Kaggle es la plataforma líder mundial de Data Science, Machine Learning e Inteligencia Artificial. Fundada en 2010 por Anthony Goldbloom y Jeremy Howard en Melbourne, Australia, fue adquirida por Google en marzo de 2017. Hoy es una subsidiaria de Google LLC y el punto de encuentro más importante para científicos de datos, ingenieros e investigadores de todo el mundo.
La plataforma comenzó exclusivamente como un sitio de competencias de Machine Learning, pero ha evolucionado hasta convertirse en un ecosistema completo que integra aprendizaje, colaboración, computación en la nube y visibilidad profesional.
Dato Clave (2024): Al 28 de mayo de 2024, Kaggle contaba con más de 18.5 millones de cuentas registradas, con 2.745 usuarios que habían alcanzado el estatus de Maestro y 530 que habían alcanzado el estatus de Gran Maestro. La comunidad abarca 194 países. [Fuente 1]
1.2 Crecimiento Histórico
Año
Hito
Significado
2010
Fundación de Kaggle
Inicia con competencias de ML
2017
Adquisición por Google
Respaldo de infraestructura global
Jun 2017
1 millón de usuarios
Primera gran comunidad de DS
Oct 2023
15 millones de usuarios
Crecimiento masivo post-pandemia
May 2024
18.5 millones de cuentas
Plataforma dominante global
2025
5-Day Gen AI Course
30.000 usuarios nuevos en 1 día
Según el estudio «Kaggle Chronicles: 15 Years of Competitions», eventos como el 5-Day Gen AI Intensive Course con Google atrajeron la mayor cantidad de usuarios nuevos en un solo día, con 30.000 nuevos registros. [Fuente 2]
1.3 La Metáfora del Ecosistema
Una forma útil de entender Kaggle es como la unión de varias plataformas en una sola:
Kaggle equivale a…
Por qué
GitHub
Repositorio público de notebooks y código
Coursera
Cursos gratuitos con ejercicios prácticos
Leetcode
Competencias con problemas reales del sector
Google Colab
Computación en la nube con GPU/TPU gratis
LinkedIn
Portafolio profesional visible para reclutadores
CAPÍTULO 2: TODO LO QUE PUEDES HACER EN KAGGLE
2.1 Notebooks con GPU Gratuita
Los Kaggle Notebooks son entornos Jupyter alojados en la nube que te permiten escribir y ejecutar código Python o R sin instalar nada en tu computadora. La característica más poderosa es el acceso gratuito a GPUs NVIDIA de alto rendimiento.
Recurso
Especificaciones
Límite Semanal
GPU T4 / P100
16 GB VRAM, NVIDIA Tesla
~30 horas/semana
TPU v3-8
Unidad de procesamiento tensorial
~20 horas/semana
CPU
4 núcleos
Sin límite
RAM
32 GB (aumentado desde 29 GB)
Por sesión
Almacenamiento
20 GB por notebook
Por proyecto
Sesión máxima GPU
9 horas continuas
Por ejecución
Sesión máxima CPU
12 horas continuas
Por ejecución
Kaggle proporciona acceso a GPUs Tesla T4 y P100, junto con TPUs. Cada sesión permite hasta 12 horas de tiempo de ejecución para sesiones de CPU y GPU, y 9 horas para sesiones TPU, con una cuota semanal de aproximadamente 30 horas de tiempo de GPU. Estos límites son predecibles y consistentes: siempre sabes lo que obtendrás. [Fuente 3]
2.2 Competencias (Competitions)
Las competencias son el corazón histórico de Kaggle. Empresas, gobiernos y organizaciones publican sus desafíos de datos más complejos con premios en dinero. Los participantes compiten para construir el mejor modelo predictivo o analítico.
Tipos de Competencias
Tipo
Descripción
Premio
Featured
Patrocinadas por empresas u organizaciones. Las más prestigiosas.
Miles a cientos de miles de USD
Research
Orientadas a investigación científica. Proceso de envío no tradicional.
Pequeño o ninguno
Playground
Para diversión y práctica. Un paso más difícil que Getting Started.
Kudos o pequeños premios
Getting Started
Para principiantes absolutos. Sin deadline, con tutoriales abundantes.
Sin premio (aprendizaje)
Recruitment
Patrocinadas por empresas que buscan reclutar científicos de datos.
Oferta laboral potencial
Un ejemplo de la magnitud de los premios: la competencia ARC Prize 2025 ofrece $725.000 USD para quien logre avanzar en el razonamiento abstracto de IA. [Fuente 4]
Consejo para Principiantes: Empieza SIEMPRE con competencias tipo «Getting Started». La más recomendada para comenzar es «Titanic: Machine Learning from Disaster», que tiene cientos de notebooks guía, una comunidad activa y sin límite de tiempo para participar.
2.3 Datasets Públicos
Kaggle alberga más de 300.000 datasets gratuitos cubriendo prácticamente cualquier dominio imaginable. Desde imágenes médicas hasta datos financieros, desde textos literarios hasta registros climáticos.
Datos estructurados (CSV, JSON, SQL)
Imágenes y video (clasificación, detección)
Texto y lenguaje natural (NLP, sentiment analysis)
Series de tiempo (finanzas, meteorología, IoT)
Datos geoespaciales y mapas
Datos médicos y biológicos
Datos de competencias históricas (Titanic, MNIST, CIFAR)
Los datasets de Kaggle incluyen características de comunidad donde puedes discutir técnicas y compartir código. El veredicto de expertos es que Kaggle es mejor para descubrir y usar datasets públicos que cualquier otra plataforma comparada. [Fuente 5]
2.4 Cursos Gratuitos (Kaggle Learn)
Kaggle Learn ofrece cursos de alta calidad con ejercicios prácticos directamente en el navegador. No requieren instalación y están diseñados para ser completados rápidamente.
Curso
Nivel
Contenido Principal
Python
Principiante
Sintaxis, funciones, listas, POO
Intro to Machine Learning
Principiante
Árboles de decisión, validación, CV
Intermediate ML
Intermedio
XGBoost, pipelines, missing values
Data Visualization
Principiante
Seaborn, matplotlib, gráficos
Pandas
Principiante/Intermedio
DataFrames, groupby, merge
SQL
Principiante/Intermedio
Consultas, joins, funciones de ventana
Deep Learning
Avanzado
Redes neuronales, CNN, transfer learning
NLP
Avanzado
Tokenización, embeddings, transformers
Intro to AI Ethics
Todos
Sesgo, equidad, privacidad en IA
Generative AI
Intermedio
LLMs, prompting, APIs de IA generativa
El formato de los cursos es ideal para principiantes: aprendes un concepto, lo practicas, y avanzas al siguiente. Los cursos de Kaggle Learn no explican las matemáticas detrás de los algoritmos, sino que enseñan los principios prácticos necesarios para un científico de datos. [Fuente 6]
2.5 Sistema de Rankings y Medallas
Kaggle tiene un sistema de progresión por rangos que recompensa la participación en cuatro categorías independientes: Competencias, Notebooks, Datasets y Discusiones.
Rango
Requisito General
Beneficio
Novice
Cuenta creada
Acceso básico a la plataforma
Contributor
Completar perfil y acciones básicas
GPU desbloqueada, API activa
Expert
Medallas en competencias o notebooks
Reconocimiento comunitario
Master
Múltiple medallas de oro
Alta visibilidad para empleadores
Grandmaster
Élite global (530 personas en 2024)
El máximo honor en Kaggle
CAPÍTULO 3: COMPUTACIÓN CON GPU EN KAGGLE
3.1 Por Qué la GPU es Fundamental en ML/DL
Las GPUs (Unidades de Procesamiento Gráfico) son esenciales en Deep Learning porque pueden ejecutar miles de operaciones matemáticas en paralelo. Mientras una CPU moderna tiene 8-32 núcleos, una GPU Tesla T4 tiene 2.560 núcleos CUDA. Esto la hace entre 10x y 100x más rápida para entrenar redes neuronales.
Característica
CPU (típica)
GPU T4 (Kaggle)
Núcleos
8-32 núcleos
2.560 núcleos CUDA
Memoria
RAM del sistema
16 GB VRAM dedicada
Operaciones FP32
~500 GFLOPS
~8 TFLOPS
Entrenamiento ResNet-50
~2 horas
~5 minutos
Costo en Kaggle
Gratis
Gratis (30h/semana)
Habilitar y utilizar una GPU en Kaggle puede mejorar drásticamente el rendimiento de tus flujos de trabajo de Machine Learning, particularmente para Deep Learning y otras tareas de alto consumo de recursos. [Fuente 7]
3.2 Cómo Activar la GPU Paso a Paso
Ve a kaggle.com y haz clic en «Code» en el menú principal.
Selecciona «New Notebook» para crear un nuevo entorno.
En el panel derecho busca la sección «Accelerator».
Selecciona «GPU T4 x2» o «GPU P100» según disponibilidad.
Verifica tu número de teléfono si aún no lo has hecho (requisito para GPU).
El notebook se reiniciará automáticamente con la GPU activa.
3.3 Verificación de GPU en Python
python
# Celda 1: Verificar GPU con nvidia-smi
!nvidia-smi

# Celda 2: Verificar con PyTorch
import torch
print("CUDA disponible:", torch.cuda.is_available())
print("Nombre GPU:", torch.cuda.get_device_name(0))
print("VRAM total:", round(torch.cuda.get_device_properties(0).total_memory / 1e9, 2), "GB")

# Celda 3: Verificar con TensorFlow
import tensorflow as tf
gpus = tf.config.experimental.list_physical_devices("GPU")
print("GPUs disponibles:", len(gpus))
for gpu in gpus:
    print("GPU:", gpu.name)
3.4 Hola Mundo con CUDA en Kaggle
Para programación directa en CUDA (C/C++) en Kaggle, usa la extensión nvcc4jupyter:
bash
# Paso 1: Instalar la extensión CUDA para Jupyter
!pip install nvcc4jupyter
%load_ext nvcc4jupyter
cuda
%%cuda
#include <stdio.h>

__global__ void saludo_gpu() {
    int idx = blockIdx.x * blockDim.x + threadIdx.x;
    printf("Hola desde hilo %d, bloque %d del GPU!\n", threadIdx.x, blockIdx.x);
}

int main() {
    printf("Inicio desde la CPU\n");
    // Lanzar 3 bloques con 8 hilos cada uno = 24 hilos paralelos
    saludo_gpu<<<3, 8>>>();
    cudaDeviceSynchronize();
    printf("Fin desde la CPU\n");
    return 0;
}
Este ejemplo demuestra el modelo SIMT (Single Instruction, Multiple Threads) de CUDA: un solo kernel se ejecuta en paralelo en todos los hilos definidos, cada uno con su propio threadIdx y blockIdx.
3.5 Ventajas de Kaggle para Computación NVIDIA
Acceso a GPU real sin necesidad de comprar hardware costoso
Soporte completo de CUDA y cuDNN preinstalados
Compatible con TensorRT para inferencia optimizada
Posibilidad de trabajar con datasets de cientos de GB en la nube
Entorno estable con PyTorch, TensorFlow y JAX preconfigurados
Comparado con Google Colab, Kaggle ofrece límites de GPU predecibles y consistentes [Fuente 3]
CAPÍTULO 4: GUÍA COMPLETA PASO A PASO PARA EMPEZAR
4.1 Registro y Configuración Inicial
Paso 1 — Registro Ve a www.kaggle.com. Puedes registrarte con tu cuenta de Google (recomendado) o con un email. El proceso toma menos de 2 minutos.
Paso 2 — Completar Perfil (Obligatorio para GPU) Ve a tu perfil > Settings. Completa tu nombre, ocupación y experiencia. Luego verifica tu número de teléfono: esto es OBLIGATORIO para activar el acceso a GPU. Ve a Account > Phone Verification.
Paso 3 — Explorar la Plataforma Familiarízate con el menú: Competitions, Datasets, Code, Models, Learn y Discussions. Pasa 20 minutos navegando sin presión antes de empezar a trabajar.
Paso 4 — Tu Primer Notebook Ve a Code > New Notebook. Selecciona Python como lenguaje. En el panel derecho activa GPU. Escribe print("Hola Kaggle!") y presiona Run All. Ya estás ejecutando código en la nube.
Paso 5 — Primera Competencia: El Titanic Busca «Titanic» en Competitions. Es la competencia de introducción clásica. Tiene miles de notebooks guía, no tiene deadline y es perfecta para aprender el flujo completo: datos → modelo → submission.
4.2 Anatomía de una Competencia de Kaggle
Entender la estructura de una competencia es esencial para participar con éxito. Cada competencia tiene estas secciones:
Overview: Descripción del problema, contexto real y objetivos específicos.
Data: Datasets de entrenamiento y prueba para descargar y analizar.
Evaluation: Métrica con la que se mide tu modelo (Accuracy, RMSE, AUC, etc.).
Rules: Elegibilidad, formación de equipos, límites de envíos diarios.
Notebooks: Código público compartido por otros participantes.
Discussion: Foro activo con preguntas, estrategias e ideas.
Leaderboard: Ranking en tiempo real de todos los participantes.
En una competencia típica de Kaggle existen tanto un leaderboard público como uno privado. El público es visible durante la competencia; el privado revela los resultados finales. Esta estructura prueba que tu modelo no solo memorice los datos de prueba. [Fuente 4]
CAPÍTULO 5: ESTRATEGIAS PARA MAXIMIZAR TU APRENDIZAJE
5.1 Hoja de Ruta Recomendada para Principiantes
Semana
Tarea
Objetivo
1-2
Curso Python en Kaggle Learn
Dominar sintaxis básica
3-4
Curso Intro to Machine Learning
Entender el ciclo ML
5-6
Explorar 3 datasets públicos
Practicar análisis EDA
7-8
Competencia Titanic
Primer submission real
9-12
Curso Intermediate ML + Pandas
Mejorar pipelines
13-16
2da competencia Getting Started
Consolida técnicas
17-24
Primera competencia Playground
Competir con premios
25+
Featured competitions
Portafolio profesional
5.2 Cómo Aprovechar los Notebooks Públicos
Una de las prácticas más valiosas en Kaggle es estudiar los notebooks de otros participantes. El botón «Copy and Edit» (o Fork) te permite clonar cualquier notebook público a tu cuenta y modificarlo libremente.
Busca notebooks con muchos votos (medalla de plata u oro).
Lee el código línea por línea sin ejecutarlo primero.
Anota las técnicas que no reconoces y búscalas.
Modifica parámetros y observa cómo cambian los resultados.
Publica tu versión mejorada con notas propias para ganar visibilidad.
Según DataCamp, estudiar los notebooks compartidos en competencias es una de las formas más efectivas de aprender enfoques diferentes para resolver el mismo problema. Las discusiones con los ganadores sirven como mentoría gratuita. [Fuente 8]
5.3 Construir un Portafolio Profesional
Kaggle funciona como un portafolio activo que los reclutadores de empresas de tecnología conocen y valoran. Un perfil sólido en Kaggle puede abrirte puertas que un CV tradicional no puede.
Estrategia de Portafolio: Publica al menos 3 notebooks de alta calidad con: descripción detallada del problema, análisis exploratorio visual, modelo bien comentado y conclusiones claras. Usa markdown para explicar tus razonamientos. Un notebook bien documentado vale más que diez códigos sin contexto.
5.4 Tendencias Tecnológicas en Kaggle (2022-2025)
Según el estudio «Kaggle Chronicles» que analizó 15 años de datos de la plataforma, las tendencias más significativas son:
Python domina con ~95% de todos los notebooks. R ha declinado sostenidamente desde 2016.
Hay una fuerte transición de métodos basados en árboles hacia Deep Learning y arquitecturas Transformer.
Los frameworks más recientes (2022-2025) reflejan un cambio hacia modelos generativos y pipelines AutoML.
Los temas más discutidos incluyen interpretabilidad, reproducibilidad y automatización.
Las competencias de «Code Competitions» son cada vez más comunes, requiriendo enviar código en lugar de predicciones.
[Fuente 2: Kaggle Chronicles: 15 Years of Competitions, Community and Data Science Innovation, ResearchGate 2025]
CAPÍTULO 6: RECURSOS ESENCIALES Y HERRAMIENTAS
6.1 Recursos Oficiales de Kaggle
Recurso
URL
Para qué sirve
Kaggle Learn
kaggle.com/learn
Cursos gratuitos oficiales
Competitions
kaggle.com/competitions
Todas las competencias activas
Datasets
kaggle.com/datasets
300K+ datasets gratuitos
Code (Notebooks)
kaggle.com/code
Notebooks públicos y propios
Models
kaggle.com/models
Modelos pre-entrenados
Discussions
kaggle.com/discussions
Foros y comunidad
Kaggle API
github.com/Kaggle/kaggle-api
CLI para automatización
Blog Oficial
medium.com/kaggle-blog
Noticias y winner writeups
6.2 Competencias Emblemáticas para Aprender
Competencia
Tipo de Problema
Nivel
Por qué Hacerla
Titanic: ML from Disaster
Clasificación binaria
Principiante
Clásico inicial, miles de guías
House Prices: Advanced Regression
Regresión
Principiante
Feature engineering real
Digit Recognizer
Visión por computadora
Principiante
Intro a CNN con MNIST
NLP with Disaster Tweets
NLP / Clasificación
Intermedio
Primer proyecto NLP real
Dogs vs Cats
Visión Computacional
Intermedio
Transfer learning práctico
ARC Prize 2025
IA de propósito general
Experto
Premio $725.000 USD
6.3 Herramientas y Bibliotecas Esenciales
Categoría
Bibliotecas Clave
Uso Principal
Datos
pandas, numpy, polars
Manipulación y análisis de datos
Visualización
matplotlib, seaborn, plotly
Gráficos y EDA
ML Clásico
scikit-learn, xgboost, lightgbm
Modelos no neuronales
Deep Learning
PyTorch, TensorFlow, Keras
Redes neuronales
NLP
HuggingFace transformers, NLTK
Procesamiento de texto
Visión
OpenCV, Pillow, albumentations
Procesamiento de imágenes
CUDA
cuDNN, cuBLAS, nvcc4jupyter
Programación GPU directa
AutoML
optuna, hyperopt, FLAML
Optimización automática
6.4 Recursos de Aprendizaje Complementarios
Plataforma
Tipo de Contenido
Costo
fast.ai
Cursos top-down de DL práctico
Gratuito
Coursera ML Specialization (Andrew Ng)
Fundamentos ML
Auditoría gratuita
Deep Learning.AI
Especialización DL completa
Auditoría gratuita
HuggingFace Course
NLP y transformers modernos
Gratuito
StatQuest (YouTube)
Estadística y ML con ejemplos visuales
Gratuito
NVIDIA DLI
Cursos oficiales de GPU y CUDA
Algunos gratuitos
Papers With Code
Papers + código de los mejores modelos
Gratuito
Towards Data Science
Artículos prácticos de comunidad DS
Freemium
CAPÍTULO 7: CÓMO HACER TUS NOTEBOOKS SEO-FRIENDLY Y VISIBLES
7.1 Por Qué la Visibilidad Importa en Kaggle
Un notebook excelente pero invisible no te ayudará a conseguir empleo ni a construir reputación. Kaggle utiliza su propio sistema de ranking que premia la calidad, originalidad y engagement de tus contribuciones.
7.2 Mejores Prácticas para Notebooks con Alta Visibilidad
Título descriptivo: Usa palabras clave del problema + técnica + resultado. Ej: «XGBoost + Feature Engineering: 0.892 AUC en Titanic»
Descripción en markdown: Explica el problema, tu enfoque y las conclusiones principales al inicio del notebook.
Sección de EDA visual: Los notebooks con muchas visualizaciones reciben más votos.
Código comentado: Cada celda importante debe tener una explicación en texto.
Compartir en Discussion: Publica tu notebook en el foro de la competencia con una breve descripción.
Responder comentarios: La interacción aumenta tu visibilidad en el algoritmo de Kaggle.
Tags relevantes: Agrega todos los tags pertinentes (pytorch, xgboost, nlp, etc.).
7.3 Palabras Clave SEO Relevantes para Kaggle
Keyword Principal
Keyword Secundaria
Intención de Búsqueda
kaggle tutorial
kaggle para principiantes
Aprendizaje
kaggle competitions
kaggle machine learning
Competencias
kaggle gpu gratis
gpu cloud gratuita
Computación
kaggle notebook python
jupyter en la nube
Herramientas
kaggle dataset
datasets públicos ml
Datos
kaggle titanic
primer proyecto data science
Principiantes
kaggle grandmaster
como ganar en kaggle
Avanzados
REFERENCIAS Y FUENTES CITADAS
[1] Wikipedia. «Kaggle». Consultado en mayo 2025. Estadísticas al 28 de mayo de 2024: 18.5 millones de cuentas, 2.745 Masters, 530 Grandmasters, presencia en 194 países. https://es.wikipedia.org/wiki/Kaggle
[2] Kaggle Chronicles: 15 Years of Competitions, Community and Data Science Innovation. ResearchGate, noviembre 2025. Incluye análisis de crecimiento, tecnologías dominantes y estadísticas de eventos. https://www.researchgate.net/publication/397480703
[3] Lalatendu Keshari Swain. «Kaggle vs Google Colab: Which Cloud Notebook Platform Should You Choose in 2026?» Medium, febrero 2026. GPU T4/P100, 30 horas/semana, sesiones de hasta 12 horas. https://lalatenduswain.medium.com
[5] Lalatendu Keshari Swain. «Kaggle vs Google Colab 2026». Medium. Comparativa de plataformas, datasets, reproducibilidad y GPU.
[6] TeckBakers. «Kaggle 101: A Beginner’s Guide to Data Science Competitions». Hashnode, febrero 2024. Descripción de Kaggle Learn, tipos de usuarios, sistema de rangos. https://teckbakers.hashnode.dev
[11] Coursera Staff. «What Is Kaggle and What Is It Used For?», octubre 2025. Definición, competencias, datasets y uso profesional. https://www.coursera.org/articles/kaggle
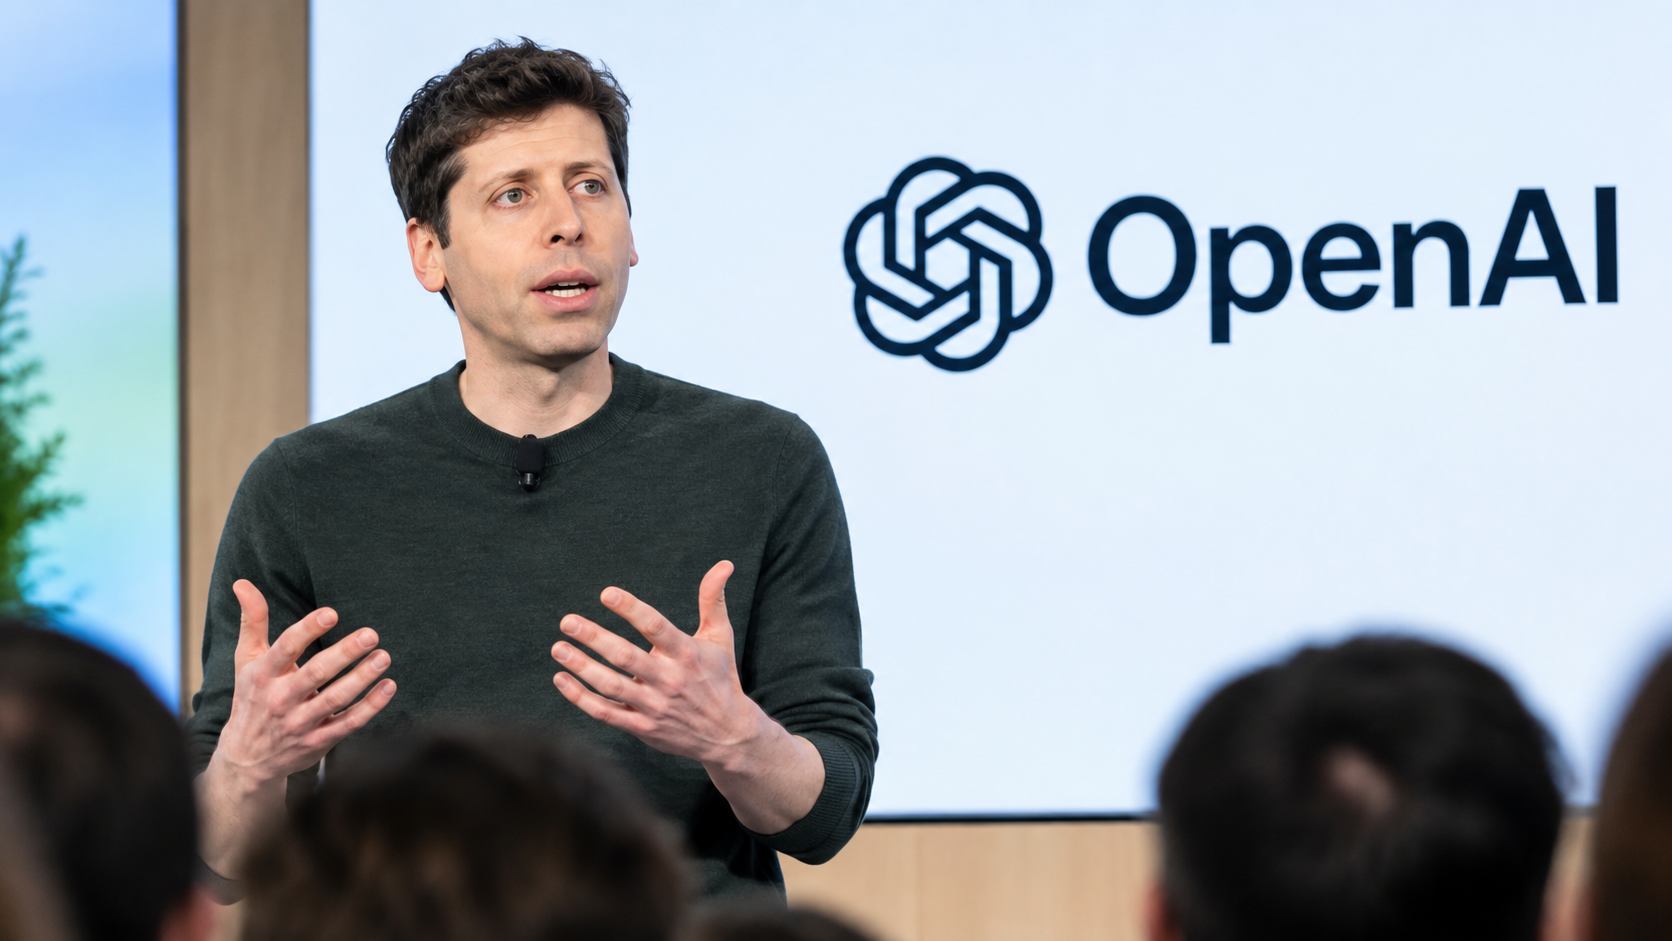
OpenAI presentó este martes en su evento DevDay 2026 a Dots, una nueva generación de agentes de inteligencia artificial capaces de operar de forma continua en segundo plano, con su propio ordenador en la nube y conexión a más de 4.000 aplicaciones. Tal como pude observar en la transmisión en directo del evento, el CEO Sam Altman los definió como agentes “always-on” diseñados para perseguir objetivos de manera autónoma, no solo responder consultas. El anuncio marca un salto en la carrera por la IA agente y ya genera fuerte interés en búsquedas.
La compañía describió a los Dots como “agentes notablemente capaces, siempre activos y construidos para manejarlo todo”. Impulsados por el modelo GPT-6 Astra, cada Dot dispone de su propia computadora en la nube, un navegador propio y la capacidad de conectarse a un ecosistema de plugins que supera las 4.000 apps. El usuario puede asignarle un objetivo y el agente continúa trabajando incluso cuando no está interactuando activamente: investiga, analiza datos, prepara documentos, corrige bugs o actualiza propuestas. Es posible abrir en cualquier momento la computadora del Dot para inspeccionar su progreso, y también se puede autorizar el acceso a la propia laptop del usuario. La interacción se realiza a través de ChatGPT (web, desktop y mobile), Slack, Microsoft Teams y, próximamente, mensajes de texto y llamadas de voz. El primer Dot está incluido sin costo adicional en los planes Pro y Business Premium en mercados elegibles, mientras que los usuarios Enterprise pueden habilitarlo mediante un administrador.
Este movimiento se inscribe en una competencia cada vez más intensa por los agentes autónomos. Meta había lanzado semanas antes su propio agente Muse, y otras firmas avanzan en soluciones similares. OpenAI responde con una propuesta orientada tanto al usuario individual de alto consumo como al segmento empresarial, donde prevé “specialist Dots” con identidad propia, credenciales específicas y profundas integraciones en sistemas corporativos. Ya trabaja con Microsoft para integrar estos agentes especializados en los controles de seguridad de Agent 365. En el evento se mostraron ejemplos concretos: un desarrollador que delega el monitoreo de feedback de clientes y la generación de fixes; un científico que actualiza análisis con nuevos datos; o un creador de contenido que automatiza clips, notas y posts. El énfasis estuvo puesto en que el agente aprende las preferencias del usuario con el tiempo y solo actúa de forma proactiva en modo de lectura cuando no hay interacción directa, reservando las acciones sensibles (como cambios de contraseña) a la aprobación explícita del humano.
Para el mercado y los actores involucrados, el lanzamiento refuerza la apuesta de OpenAI por monetizar capacidades de alto valor a través de sus planes pagos más caros, en un momento en que la adopción empresarial de IA generativa sigue creciendo. Los Dots no consumen los límites de uso de ChatGPT en las conversaciones normales, aunque las tareas más pesadas en Codex o ChatGPT Work sí impactan en las cuotas. En el plano de la seguridad, la compañía subrayó salvaguardas adicionales: cada agente opera en un entorno aislado, existen reglas personalizables de aprobación y sistemas de monitoreo que pueden pausar el trabajo ante comportamientos riesgosos. Aun así, el propio Altman y la industria reconocen que el pasaje de chatbots a agentes autónomos eleva los desafíos de control y responsabilidad. En Argentina y la región, donde muchas pymes y profesionales ya incorporan herramientas de IA para ganar productividad en contextos de alta inflación y presión de costos, este tipo de agentes podría acelerar la automatización de tareas rutinarias, aunque el acceso inicial quedará limitado a quienes puedan solventar los planes premium.
Las perspectivas apuntan a una expansión gradual. OpenAI anticipó que con el tiempo se podrán formar equipos de Dots que colaboren entre sí y que se sumarán más usuarios. El interés ya se reflejó en picos de búsquedas asociados al término y al propio DevDay. Si la ejecución cumple con las promesas de autonomía controlada, los Dots podrían transformar la forma en que se delegan proyectos complejos, pasando de una interacción puntual a una relación de trabajo continuo. Quedará por ver cómo se resuelven los dilemas de confianza, costos reales de uso intensivo y regulación a medida que estos agentes se masifiquen.
Camila Soria junto con SuperPioneros hicieron una presentación al respecto, Acá les presento un resumen de la misma junto al grupo Pioneros — la comunidad de Web3, IA e innovación liderada por José Luis Cáceres (CEO de NWC10, fundador de SuperPioneros y CBO de Bit2Me), que reúne a más de 80.000 personas aprendiendo, ayudando y construyendo juntas en el ecosistema. Los sigo hace años, y no es casualidad que este tema haya salido justo de ese espacio: son de los que están un paso adelante marcando por dónde va el debate técnico y legal de la industria en habla hispana.
La presentación de Camila Soria (CipherLaw)
Camila Soria es Chief Legal Architect en CipherLaw, estudio de Buenos Aires especializado en infraestructura legal estratégica para Web3 e IA. El material es la primera edición de «Legal Design for Builders», creada junto a NWC10 | SuperPioneros.
Su planteo, en sus propias palabras (post de LinkedIn que acompaña la presentación):
«Un agente puede tener permiso técnico para operar una wallet y, aun así, no tener autoridad para realizar cualquier operación.»
Durante la charla analizaron qué cambia cuando la IA deja de recomendar y empieza a decidir, firmar y ejecutar pagos. Su conclusión principal: los límites críticos no pueden vivir solamente en un prompt. El monto, la contraparte, la vigencia, las operaciones permitidas y la posibilidad de revocar el acceso tienen que formar parte de la arquitectura del sistema, no de una instrucción en lenguaje natural.
También plantea la necesidad de poder reconstruir la cadena completa — mandato → decisión → control → firma → ejecución — porque cuando algo sale mal, esa evidencia es lo que permite entender dónde ocurrió la falla y quién estaba en mejores condiciones de evitarla.
Las siete ideas centrales, en el orden del documento:
Del agente que habla al agente que paga: «Para el agente que habla, el derecho ya respondió. Para el que paga, recién empieza.»
«Autónomo» no significa lo mismo para todos: «Que vos definas el destino no significa que controles todo el camino.»
El regulador no mira solo el stack técnico: evalúa dominio, acción y derechos afectados — la combinación define el «perfil regulatorio».
Permiso no es lo mismo que autoridad: la autoridad real se define por monto, contraparte, vigencia y tipo de operación.
Quien razona no debería autorizar: «El agente puede razonar. No debería darse permiso a sí mismo.»
Un prompt no es un control: «Dale una llave de hotel, no una llave maestra.»
La responsabilidad sigue al control y al beneficio: como el agente no tiene patrimonio propio, la responsabilidad recae en quien controla el sistema y se beneficia de él.
Cierre su presentación y documento con lo siguiente, si construís agentes que actúan, también tenés que diseñar quién responde por sus acciones.
Fuente: Camila Soria (CipherLaw), presentación «Legal Design for Builders» — primera edición, creada junto a NWC10 | SuperPioneros, LinkedIn.
Mi visión adicional al documento de Camila (agregado, no parte del documento)
Hoy conviven dos modelos de agentes: unos con límite libre y otros con tarjetas prepagas recargables, con tope fijo controlado por un humano. Mastercard lanzó Agent Pay el 17 de septiembre de 2026 junto a Alchemy, donde el usuario define límites configurables: tope de gasto, categorías de comercio permitidas y geografías habilitadas, permitiendo que el agente compre sin pedir autorización en cada transacción, pero siempre dentro de esos parámetros. Fuente: Mastercard lanza Agent Pay con Alchemy — Ecosistema Startup
Si un agente se equivoca, el problema es de programación, no «de la IA»: conecta con el punto 5 del documento — un agente bien diseñado debería derivar a un humano antes de ejecutar una decisión compleja, en vez de resolverlo todo por sí solo.
El FSB (Consejo de Estabilidad Financiera) ya pide ese mismo control a nivel bancario: pidió que bancos limiten la IA agéntica y traten a los agentes como ‘empleados sintéticos’, con aval humano para transacciones por encima de ciertos montos. Fuente: Let’s Money — IA Agéntica
Argentina y la «Sociedad Automatizada»: el gobierno tiene en el Senado un proyecto de ley que introduce esta figura. Según el artículo 14, «la sociedad automatizada responde con su patrimonio frente a terceros por los daños causados por sus sistemas algorítmicos autónomos o agentes de inteligencia artificial». Fuente: Xataka — Milei quiere crear nueva categoría empresarial
Bots que se clonan si ganan y se apagan si pierden: conecta con una tendencia que recién empieza a circular en la industria, los «self-evolving agents». Vale aclarar que esto hoy es más una tendencia conceptual que algo funcionando en producción con dinero real. Fuente: Baguete — Vem aí os self-evolving agents
Mirada a futuro: avanzar, pero con cautela y por etapas (opinión propia)
Siguiendo el planteo de Camila Soria como base, mi lectura de hacia dónde debería ir esto es la siguiente: el futuro es avanzar, pero de forma gradual, no de golpe.
En una primera etapa, tiene sentido que los agentes de IA operen únicamente con tarjetas prepagas y topes bajos, sin manejar grandes volúmenes de dinero. No porque la tecnología no esté lista, sino porque el marco legal todavía no lo está — y como bien marca Soria, sin autoridad clara y sin control técnico real, cualquier volumen grande es un riesgo innecesario. Empezar chico, con montos acotados y recargables, permite que la industria (y la ley) vayan madurando al mismo ritmo que la tecnología, en vez de que la tecnología corra sola y la ley llegue tarde a poner orden.
Ahí es donde entra lo que estamos construyendo en AuriTrace.com: trazabilidad de lo que hacen los agentes de IA, siguiendo patrones que deben cumplirse, con la posibilidad de registrar esa información en una blockchain. Esto conecta directo con uno de los pedidos centrales de Camila Soria en el documento — poder reconstruir la cadena completa de mandato → decisión → control → firma → ejecución. Un registro en blockchain le da a esa cadena algo clave: evidencia inmutable y verificable, exactamente lo que hace falta cuando algo sale mal y hay que determinar quién estaba en mejores condiciones de evitar la falla.
En resumen: la tecnología para que los agentes paguen y actúen solos ya existe. Lo que falta madurar es el círculo completo — tope de gasto controlado por humanos, trazabilidad verificable de cada acción, y un marco legal claro sobre quién responde. Avanzando en ese orden, por etapas, se puede construir un ecosistema de agentes de IA confiable sin repetir errores que después sean difíciles de deshacer. Vos que opinás a la presentación de Camila?? cuales son tus sugerencias.. el futuro lo vamos construyendo entre todos.
OpenAI confirmó el 1 de septiembre que su próximo modelo de frontera, llamado Astra, alcanzó el umbral de capacidad «crítica» en ciberseguridad dentro de su Marco de Preparación (Preparedness Framework), la calificación más alta que la compañía asigna a un modelo y la primera vez que designa un sistema en ese nivel. Según la publicación técnica de la empresa, titulada «Path to Astra», el modelo puede identificar fallas de seguridad desconocidas y desarrollar formas de explotarlas en sistemas altamente protegidos sin que una persona lo guíe paso a paso.
OpenAI había advertido en agosto que no podía descartar que Astra alcanzara ese nivel y, como consecuencia, frenó partes del desarrollo del modelo mientras reforzaba y probaba salvaguardas contra el uso malicioso y las acciones no autorizadas del sistema. Tras esas pruebas adicionales, la compañía concluyó que las protecciones actuales minimizan de forma suficiente el riesgo de daño severo como para habilitar el lanzamiento. El despliegue será escalonado: las capacidades ofensivas más avanzadas del modelo estarán disponibles primero para un grupo reducido de organizaciones que integran la coalición de ciberseguridad Daybreak, con claves de seguridad de hardware obligatorias para todas las cuentas desde el 1 de septiembre.
El anuncio marca un punto de inflexión para toda la industria de modelos de frontera: es la primera vez que un desarrollador documenta públicamente que uno de sus sistemas cruzó la línea de «crítico» en un marco de autoevaluación de riesgos, y la Casa Blanca confirmó que OpenAI informó voluntariamente sobre la decisión de demorar el lanzamiento. Auditores externos, incluido el Instituto de Seguridad de IA del Reino Unido, participaron de pruebas adicionales sobre el modelo antes de esta designación, un nivel de escrutinio inusual para una compañía privada.
La dimensión humana del caso es doble: por un lado, un modelo con esa capacidad podría convertirse en una herramienta defensiva poderosa para equipos de seguridad que hoy enfrentan una escasez crónica de talento especializado; por el otro, la misma capacidad, si cae en manos equivocadas o escapa a los controles de acceso escalonado, podría automatizar ataques que hasta ahora requerían equipos humanos altamente calificados. La pregunta que queda planteada para el resto de la industria de IA es si otros laboratorios llegarán pronto al mismo umbral y qué estándares comunes de acceso restringido deberían adoptarse antes de que eso ocurra.









 AI1 año ago
 Nano1 año ago

 AI10 meses ago

 AI1 año ago