La premisa es radical: en lugar de construir circuitos con silicio y cobre, ¿qué pasa si construimos circuitos con genes y proteínas? La biología ya lleva 4.000 millones de años procesando información. La biología sintética propone hacerlo por diseño, no por evolución.
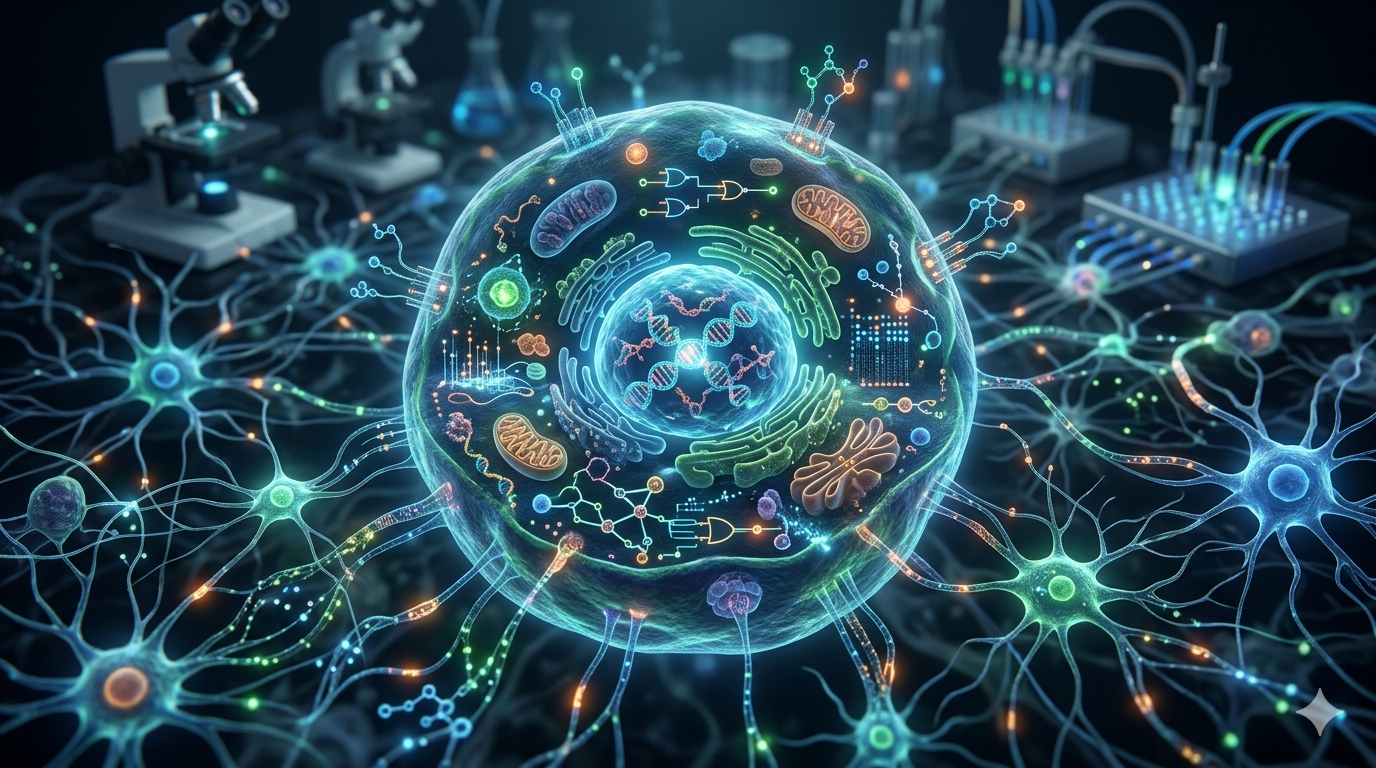
El campo parte de una observación simple: una célula viva ya es una computadora. Recibe señales del entorno (inputs), las procesa a través de redes de regulación génica, y produce respuestas (outputs). Lo que hace la biología sintética es intervenir ese sistema para programar comportamientos que la evolución nunca diseñó.
No es ciencia ficción. En 2025, el campo pasó de experimentos de laboratorio a aplicaciones que operan en entornos reales: desde células que detectan tumores en el torrente sanguíneo hasta prototipos de almacenamiento de datos en ADN que superan por miles de órdenes de magnitud la densidad del silicio.
Los cuatro pilares del biocomputing
El biocomputing descansa sobre cuatro ideas centrales que se desarrollan de forma paralela y cada vez más convergente.
El primero son los circuitos genéticos lógicos: genes ensamblados para comportarse como compuertas AND, OR, NOT y NAND. Reciben moléculas como input y producen proteínas como output, funcionando como el equivalente biológico de una compuerta lógica electrónica. El segundo pilar es el ADN como medio de almacenamiento de datos: la información digital se traduce a secuencias de bases nitrogenadas A, T, C y G, se sintetiza químicamente, y puede leerse después mediante secuenciación. Un gramo de ADN puede contener teóricamente 215 petabytes de información, lo que equivale a reducir un depósito entero de cintas magnéticas a una caja de zapatos.
El tercer pilar son las células como sensores inteligentes: organismos vivos programados para detectar biomarcadores específicos —proteínas de cáncer, toxinas ambientales— y responder con una acción terapéutica directa desde adentro del cuerpo, sin intervención médica externa. El cuarto son los organismos como fábricas: bacterias o levaduras reprogramadas para producir medicamentos, materiales o combustibles, usando el metabolismo celular como línea de producción industrial.
Cómo funciona un circuito genético
La lógica es directamente análoga a la electrónica digital. Una compuerta AND genética activa su output solo si dos proteínas regulatorias específicas están presentes simultáneamente. Una compuerta NOT suprime el gen de salida cuando su input se activa. Una compuerta OR produce su respuesta si al menos una de las condiciones de entrada se cumple. Combinando estas compuertas se construyen circuitos que toman decisiones complejas dentro de una célula viva.
Un ejemplo concreto: investigadores de la Universidad Médica de Lublin publicaron en 2023 circuitos basados en split Cas9 —una variante dividida del sistema CRISPR— capaces de detectar el origen celular, la transición epitelial-mesenquimal y la fusión célula-célula, usando compuertas AND para distinguir células cancerosas de células normales con alta especificidad. El sistema activa un gen reportero únicamente en células que cumplen los dos criterios simultáneamente, lo que lo hace mucho más preciso que los métodos diagnósticos convencionales.
La lógica computacional se aplica directamente al problema médico: si el paciente tiene el marcador A y el marcador B al mismo tiempo, y solo entonces, el circuito se activa. De otro modo, no hace nada.
El CPU dentro de la célula
En 2019, un equipo de investigadores publicó en las Proceedings of the National Academy of Sciences el diseño de una unidad de procesamiento central basada en CRISPR/Cas9 dentro de células humanas. Usando variantes ortogonales de Cas9 —versiones del sistema que no interfieren entre sí— construyeron un CPU multicore que ejecuta cálculos aritméticos en paralelo dentro de una célula mamífera viva.
No es una metáfora: es un sistema que integra inputs biológicos, los procesa según reglas lógicas programadas genéticamente, y produce outputs medibles. La diferencia con un CPU de silicio es que este opera en el ambiente más hostil e impredecible posible: el interior de un organismo vivo, con temperatura variable, reacciones químicas simultáneas, y la presión constante de la selección evolutiva.
ADN como disco rígido eterno
El problema de almacenamiento de datos es uno de los más urgentes del siglo: el volumen global de información crece exponencialmente mientras los medios convencionales —cintas magnéticas, discos duros— tienen una vida útil de décadas y requieren energía constante para mantenerse. El ADN lleva 4.000 millones de años almacenando información sin ningún cable de alimentación. La biología sintética aprendió a usarlo como medio de escritura deliberada.
La densidad es casi incomprensible en términos convencionales: un gramo de ADN puede almacenar teóricamente 215 petabytes de datos, mientras que un disco duro del mismo peso almacena una fracción infinitesimal de esa cantidad. Y el ADN sintético encapsulado en sílice tiene una estabilidad proyectada superior a los 1.000 años sin ningún tipo de mantenimiento ni consumo energético, lo que lo convierte en el primer medio de almacenamiento genuinamente adecuado para archivo a escala civilizatoria.
En 2025 se produjo un hito concreto: la adopción a gran escala de la síntesis enzimática de ADN (EDS), que reemplaza el proceso químico tradicional por enzimas que construyen cadenas de ADN en soluciones acuosas. Esto permitió sintetizar más de 10.000 bases con alta fidelidad, reduciendo drásticamente los costos y habilitando el primer prototipo funcional de almacenamiento a escala petabyte. El sistema demostró la capacidad de codificar, sintetizar y leer datos de miles de cadenas de ADN sintético a una densidad que supera ampliamente la de los medios basados en silicio.
Las células como médicos autónomos
La aplicación más disruptiva del biocomputing no es el almacenamiento de datos: es la medicina. Investigadores lograron en 2025 diseñar protocélulas —células mínimas sintéticas— programadas con compuertas lógicas para funcionar como diagnósticos autónomos dentro del cuerpo.
El circuito funciona así: la célula sintética detecta biomarcadores específicos de cáncer o toxinas ambientales como inputs. Si la combinación lógica de esos marcadores activa la compuerta correcta, la célula libera automáticamente una respuesta terapéutica como output. Sin médico intermediando. Sin análisis externo. El diagnóstico y el tratamiento ocurren dentro del tejido donde se necesitan.
Circuitos basados en CRISPR-Cas9 publicados en Nature Communications demostraron compuertas AND capaces de distinguir células de cáncer de vejiga de células epiteliales normales con alta especificidad. Al reemplazar el gen reportero por genes funcionales como hBAX y p21, el mismo circuito inhibió el crecimiento tumoral, indujo apoptosis y redujo la motilidad de las células cancerosas in vitro. Es el paso previo al uso clínico de células reprogramadas que detectan y tratan enfermedades desde adentro.
Cronología del campo
1994 — El origen: Leonard Adleman publica en Science la solución del problema del Circuito Hamiltoniano usando operaciones moleculares con cadenas de ADN. Es la primera demostración de que las moléculas pueden computar problemas combinatoriales.
2000 — Primeros circuitos genéticos: Los trabajos fundacionales del toggle switch y el represilador demuestran que genes pueden ensamblarse para funcionar como interruptores biestables y osciladores, sentando las bases de la lógica biológica programable.
2019 — CPU multicore en células humanas: Variantes ortogonales de Cas9 permiten computación aritmética en paralelo dentro de células mamíferas. El paper en PNAS abre la puerta al biocomputing de propósito general en tejidos vivos.
2023 — Split Cas9 para detección de eventos celulares: Compuertas AND basadas en Cas9 dividido detectan células cancerosas, transición mesenquimal y fusión celular con alta especificidad. Publicado en Scientific Reports.
2025 — Síntesis enzimática a escala industrial: La adopción masiva de EDS reduce costos y habilita el primer prototipo funcional de almacenamiento a escala petabyte en ADN. Protocélulas con compuertas lógicas operan como diagnósticos in vivo.
2026 — Convergencia con IA: La conferencia SEED 2026 —el evento central del campo— pone la aceleración por inteligencia artificial y machine learning como eje principal: diseño de proteínas, células virtuales y genomas sintéticos convergen con modelos de lenguaje grandes.
El límite que nadie menciona
El biocomputing tiene una ventaja que ningún chip de silicio puede replicar: opera dentro del sistema que busca comprender o tratar. Una célula reprogramada actúa directamente en el tejido canceroso, sin extracción de muestras ni análisis externos. Pero también tiene restricciones físicas fundamentales.
Los circuitos genéticos no pueden simplemente escalar como los electrónicos: cada proteína regulatoria nueva debe verificarse para que no interfiera con las demás —lo que los investigadores llaman ortogonalidad. El metabolismo celular tiene un presupuesto energético y molecular limitado. Y la evolución siempre está presente: un circuito que reduce la eficiencia de la célula huésped será gradualmente eliminado por selección natural, deshaciendo el diseño del ingeniero.
El debate teórico más profundo del campo gira en torno al paradigma mismo: investigadores argumentan que la lógica booleana digital —AND, OR, NOT— es fundamentalmente inadecuada para la biología, porque las células no operan en valores discretos de 0 y 1, sino en gradientes continuos de concentración molecular. Los circuitos analógicos y probabilísticos pueden representar mejor cómo computan realmente los sistemas biológicos. Esta tensión entre el paradigma digital importado de la ingeniería electrónica y la naturaleza analógica de la biología es la pregunta más abierta del campo, y su respuesta determinará qué tan lejos puede llegar el biocomputing en la práctica.
Fuentes
Adleman, L. «Molecular Computation of Solutions to Combinatorial Problems.» Science, 1994.
Péptidos: la convergencia entre inteligencia artificial, biotecnología y finanzas que abre una nueva frontera de inversión
El diseño de moléculas mediante inteligencia artificial, los avances en química y fabricación farmacéutica y la expansión de los medicamentos basados en péptidos están creando un nuevo ecosistema tecnológico y económico. El lanzamiento del ETF PEPT en Nasdaq refleja el interés de los mercados por una industria que conecta investigación científica, infraestructura productiva y capital.
Una nueva frontera donde convergen ciencia, tecnología y capital
La próxima transformación de la medicina podría estar vinculada con una de las estructuras fundamentales de la biología: los péptidos. Estas cadenas de aminoácidos participan en numerosos procesos del organismo y pueden utilizarse para desarrollar moléculas capaces de actuar sobre objetivos biológicos específicos.
Su relevancia comercial creció con los medicamentos basados en GLP-1, utilizados en el tratamiento de la diabetes tipo 2 y la obesidad. Sin embargo, el potencial de los péptidos no se limita a los tratamientos metabólicos. La investigación también explora aplicaciones en oncología, enfermedades raras, inflamación y otras áreas terapéuticas.
Lo relevante es que esta evolución ya no depende exclusivamente de la investigación farmacológica tradicional. La inteligencia artificial, la química computacional, la automatización de laboratorios y las nuevas técnicas de fabricación están modificando la forma de descubrir, desarrollar y producir moléculas terapéuticas.
Al mismo tiempo, los mercados financieros comienzan a crear instrumentos de inversión vinculados con esta cadena de valor. Los péptidos se convierten así en un caso concreto de convergencia entre innovación científica, desarrollo industrial y capital.
La inteligencia artificial entra en el diseño de moléculas
El desarrollo de un medicamento comienza con la identificación de un objetivo biológico y la búsqueda de una molécula capaz de actuar sobre él. Tradicionalmente, este proceso requiere numerosos experimentos, ciclos de optimización y años de investigación.
Las nuevas herramientas computacionales permiten explorar más alternativas y priorizar candidatos potencialmente prometedores. Los modelos de aprendizaje automático pueden ayudar a analizar secuencias de aminoácidos, estimar interacciones moleculares y orientar los experimentos de laboratorio.
En octubre de 2025, Nature Chemical Biology publicó una investigación sobre RFpeptides, un método de aprendizaje profundo orientado al diseño de péptidos macrocíclicos capaces de reconocer objetivos terapéuticos. El trabajo ilustra cómo la inteligencia artificial empieza a intervenir en etapas concretas del descubrimiento de fármacos.
La integración tecnológica comprende cinco áreas principales:
Inteligencia artificial: exploración de secuencias y priorización de candidatos moleculares.
Química computacional: simulación de estructuras, propiedades e interacciones.
Síntesis química y biotecnológica: producción de las moléculas seleccionadas.
Automatización experimental: ejecución, medición y análisis de pruebas de laboratorio.
Fabricación farmacéutica avanzada: producción a escala, purificación, formulación y control de calidad.
El objetivo es reducir incertidumbres, mejorar la selección de candidatos y acelerar determinadas etapas de investigación. No obstante, una molécula diseñada mediante inteligencia artificial no se convierte automáticamente en un medicamento eficaz y seguro. La validación experimental, los ensayos clínicos y la aprobación regulatoria siguen siendo indispensables.
La oportunidad tecnológica está en integrar estas capacidades en plataformas que conecten diseño computacional, experimentación y producción, con ciclos de aprendizaje que permitan mejorar las siguientes etapas de desarrollo.
El desafío industrial: fabricar, escalar y garantizar la calidad
El descubrimiento de una molécula constituye solamente una parte del proceso. Para transformarla en un producto farmacéutico, es necesario resolver problemas de estabilidad, biodisponibilidad, administración, seguridad y fabricación reproducible.
Algunos péptidos pueden degradarse con facilidad o presentar dificultades para atravesar las barreras biológicas. Otros requieren sistemas de administración específicos. Su producción también puede exigir procesos especializados de síntesis, purificación y análisis de impurezas.
Estas exigencias generan oportunidades para empresas que no necesariamente desarrollan medicamentos propios. Entre ellas se encuentran los fabricantes de ingredientes farmacéuticos activos, las organizaciones de desarrollo y fabricación por contrato, los proveedores de equipamiento y las compañías que desarrollan dispositivos de administración.
Por eso, el crecimiento de la industria puede distribuirse a lo largo de una cadena de valor extensa. Una innovación terapéutica puede impulsar simultáneamente la demanda de investigación, infraestructura productiva, servicios de laboratorio y tecnologías de control.
La capacidad de fabricar de manera consistente, mantener estándares de calidad y responder a una demanda creciente puede convertirse en una ventaja competitiva para los proveedores especializados.
La regulación también impulsa la evolución tecnológica
La expansión de los medicamentos basados en péptidos exige métodos adecuados para evaluar su composición, actividad biológica, impurezas y seguridad.
El 28 de julio de 2026, la Administración de Alimentos y Medicamentos de Estados Unidos (FDA) publicó 17 guías preliminares revisadas para determinados medicamentos peptídicos genéricos. Las recomendaciones contemplan aspectos como la evaluación de la respuesta inmunitaria, los umbrales de impurezas, la estructura molecular y la actividad biológica.
Entre los productos abordados figuran medicamentos basados en semaglutida, liraglutida y tirzepatida.
Estas guías no equivalen a una aprobación automática de productos genéricos. Son recomendaciones regulatorias preliminares destinadas a orientar su desarrollo y evaluación. Su importancia reside en la necesidad de establecer criterios científicos apropiados para comparar productos y garantizar estándares de calidad.
Para la industria, esto también significa que la innovación debe avanzar junto con los sistemas de validación, documentación, trazabilidad y control.
Wall Street incorpora los péptidos a la inversión temática
El 14 de octubre de 2026, REX Shares lanzó el REX Peptide ETF, identificado con el ticker PEPT y cotizado en Nasdaq.
El fondo busca replicar el VettaFi Peptide Index, un índice que reúne empresas vinculadas con distintas actividades del ecosistema de los péptidos. La propuesta amplía la exposición más allá de los laboratorios propietarios de los medicamentos más conocidos e incluye diferentes segmentos de la cadena de valor.
Entre ellos se encuentran:
Medicamentos y terapias: empresas que investigan, desarrollan y comercializan productos farmacéuticos basados en péptidos.
Fabricación y dispositivos médicos: proveedores de ingredientes, servicios especializados y tecnologías de administración.
Nutracéuticos y suplementos: empresas vinculadas con productos de consumo basados en péptidos.
Cosmética y cuidado de la piel: compañías que desarrollan aplicaciones cosméticas relacionadas con estas moléculas.
Según la metodología publicada por el emisor, el índice establece criterios de capitalización bursátil y liquidez, además de reglas para limitar la concentración de determinadas posiciones. No todas las compañías incluidas tienen necesariamente una actividad exclusiva en péptidos.
El fondo informó un gasto operativo anual del 0,65%. Como se trata de un instrumento recién lanzado, todavía debe construir un historial de rendimiento que permita evaluar su comportamiento en distintos escenarios de mercado.
El lanzamiento evidencia que existe una propuesta financiera específica para esta temática, pero no constituye por sí mismo una recomendación de compra ni una garantía de rentabilidad.
¿Dónde está la oportunidad económica?
El atractivo financiero del sector se relaciona con varios factores: la demanda de nuevos tratamientos, la expansión de las aplicaciones terapéuticas, la necesidad de capacidad productiva y el desarrollo de tecnologías que permitan mejorar los procesos de fabricación.
En su comunicado de lanzamiento, REX Shares citó una proyección de J.P. Morgan Global Research según la cual el mercado global de incretinas, que incluye medicamentos GLP-1, podría alcanzar los US$ 200.000 millones en 2030.
Esta estimación corresponde al mercado de incretinas y no al conjunto de todas las terapias basadas en péptidos. La distinción es importante porque las cifras de mercado dependen de los productos, aplicaciones y metodologías incluidos en cada cálculo.
Para los inversores, el crecimiento de una industria tampoco asegura una suba de las acciones. Las cotizaciones pueden incorporar expectativas elevadas y las compañías pueden enfrentar resultados clínicos desfavorables, competencia, restricciones regulatorias o dificultades de fabricación.
La evaluación económica requiere distinguir entre el tamaño potencial de un mercado, los ingresos que efectivamente puede capturar una empresa y la valoración que los inversores están dispuestos a pagar por esos ingresos futuros.
Una compañía puede participar en una industria en expansión y, aun así, obtener resultados inferiores a los esperados si sus costos son elevados, sus productos no alcanzan el mercado o sus acciones cotizan a valoraciones excesivas.
Los riesgos de una industria de alta innovación
La biotecnología presenta un perfil de riesgo particular porque una parte de su valor depende de investigaciones cuyo resultado todavía es incierto.
Un candidato puede mostrar resultados prometedores en laboratorio y fracasar posteriormente en ensayos clínicos. También pueden aparecer efectos adversos, dificultades para demostrar eficacia, problemas de fabricación o competencia de tratamientos alternativos.
En los fondos temáticos se agregan otros riesgos: concentración sectorial, volatilidad bursátil, exposición internacional y diferencias entre el precio de mercado y el valor de los activos subyacentes.
En el caso de PEPT, la diversificación entre distintas compañías no elimina el riesgo de que el conjunto de la industria atraviese un período desfavorable. Tampoco garantiza que todas las empresas de la cartera tengan una exposición significativa a los péptidos en sus ingresos.
Antes de invertir, resulta necesario analizar la composición efectiva del fondo, sus costos, su liquidez, la metodología del índice y el perfil de riesgo de las compañías que lo integran.
Qué significa para Argentina y América Latina
La convergencia entre inteligencia artificial y biotecnología abre interrogantes que van más allá de la inversión bursátil. También plantea oportunidades para empresas de software científico, servicios tecnológicos, automatización, análisis de datos e infraestructura de investigación.
Para Argentina y América Latina, el desafío consiste en identificar capacidades que puedan integrarse a cadenas de valor internacionales. El desarrollo de software especializado, los servicios de investigación, la formación de talento, la instrumentación y el análisis de datos son algunas de las áreas en las que pueden surgir oportunidades de colaboración.
No todas estas actividades requieren desarrollar un medicamento propio, aunque sí demandan especialización, inversión, estándares de calidad y vínculos con organizaciones que dispongan de infraestructura experimental y experiencia regulatoria.
También existe una dimensión financiera. Los inversores argentinos interesados en PEPT deben verificar su disponibilidad a través de intermediarios habilitados, los costos de operación, las condiciones de acceso al mercado estadounidense y el tratamiento fiscal correspondiente.
La oportunidad para la región no consiste únicamente en seguir las cotizaciones de las empresas internacionales. También implica evaluar qué capacidades científicas, tecnológicas e industriales pueden desarrollarse localmente para participar en esta transformación.
Una misma tendencia, dos dimensiones inseparables
Los péptidos ilustran cómo una transformación científica puede convertirse en una nueva categoría de negocio.
La inteligencia artificial contribuye a explorar moléculas; la química y la biotecnología permiten desarrollarlas; la fabricación especializada las lleva a escala; y los mercados financieros crean instrumentos para canalizar capital hacia empresas vinculadas con ese proceso.
El valor no se concentra necesariamente en una sola compañía ni en una única etapa. Puede distribuirse entre quienes descubren nuevas terapias, desarrollan plataformas tecnológicas, fabrican los productos y construyen la infraestructura necesaria para comercializarlos.
La evolución del sector dependerá de resultados científicos verificables, aprobaciones regulatorias, capacidad productiva y modelos de negocio sostenibles.
Para la industria tecnológica y para los mercados financieros, la pregunta central será qué empresas logran convertir la promesa de la biotecnología en soluciones médicas y resultados económicos concretos.
La convergencia entre ciencia, tecnología y finanzas no es solamente una tendencia de inversión: es una nueva forma de analizar cómo se crea valor en la economía del conocimiento.
Fuentes y referencias
Las siguientes fuentes permiten ampliar la información científica, tecnológica, regulatoria y financiera desarrollada en esta investigación.
1. REX Shares — lanzamiento del REX Peptide ETF (PEPT)
Comunicado oficial del 14 de octubre de 2026. Describe el objetivo del fondo, los segmentos de la cadena de valor contemplados y las proyecciones de mercado citadas por la gestora.
3. U.S. Securities and Exchange Commission (SEC) — prospecto resumido de PEPT
Documento regulatorio del REX Peptide ETF, fechado el 13 de octubre de 2026. Fuente primaria para consultar las características y los riesgos del instrumento.
5. U.S. Food and Drug Administration (FDA) — Revised draft product-specific guidances for certain generic peptide products
Comunicado del 28 de julio de 2026 sobre 17 guías preliminares revisadas para el desarrollo y la evaluación de determinados medicamentos peptídicos genéricos.
Medios: convergencia.tech y elfinancierodigital.com
Modalidad: investigación y publicación conjunta.
Enfoque: convergencia tecnológica, biotecnología, industria farmacéutica, mercados financieros e inversión temática.
Nota: las proyecciones de mercado corresponden a estimaciones atribuidas a sus respectivas fuentes. La inclusión de un instrumento financiero en este análisis no constituye una recomendación de inversión.
Una investigación desarrollada por científicos vinculados a Cornell describe un sistema de edición genética diseñado como alternativa potencial a CRISPR. Según la cobertura de BioTechniques, el sistema fue probado en bacterias y plantea una vía para ampliar el repertorio de herramientas de ingeniería genética.
CRISPR revolucionó la edición genética porque permite dirigir modificaciones a secuencias determinadas del ADN. Sin embargo, no todas las herramientas sirven para todas las aplicaciones: la eficiencia, el tipo de modificación, el tamaño del sistema y los efectos no deseados pueden limitar su uso en determinados organismos o contextos experimentales.
La demostración en bacterias es un primer paso y no prueba que la herramienta funcione con igual eficacia en células humanas, plantas o animales. Para evaluar su importancia será necesario examinar la publicación científica original, los tipos de cambios que puede realizar, las tasas de éxito y los límites de seguridad.
Una alternativa funcional podría ampliar las posibilidades de investigación en biotecnología industrial, agricultura y desarrollo de tratamientos. El interés para América Latina incluye cultivos, microorganismos industriales y salud, pero cualquier aplicación concreta deberá superar etapas de validación, evaluación de riesgos y regulación.
Nature Biotechnology publicó una investigación sobre una versión diseñada de Argonaute 2 humana para realizar edición dirigida de bases de ARN, en particular conversiones de citosina a uracilo (C-to-U). El artículo explora la posibilidad de aprovechar una proteína humana con funciones programables para superar algunas limitaciones de herramientas basadas en proteínas de otros organismos.
La edición de ARN se diferencia de la modificación directa del ADN: puede alterar instrucciones moleculares utilizadas por las células sin cambiar necesariamente la secuencia permanente del genoma. Una herramienta capaz de dirigir estas modificaciones podría ofrecer nuevas estrategias de investigación y, potencialmente, aplicaciones terapéuticas.
El trabajo se encuentra en el ámbito de la investigación científica. No debe interpretarse como la disponibilidad de un tratamiento aprobado ni como evidencia de eficacia clínica general. La precisión de la edición, los efectos fuera del objetivo, la entrega a los tejidos y la duración de los cambios requieren evaluación específica.
El avance es relevante para la convergencia entre biología molecular e ingeniería de proteínas. Para los investigadores de la región, la publicación puede orientar nuevas líneas de estudio en terapias basadas en ARN, aunque la traducción a productos médicos dependerá de la validación independiente y de ensayos posteriores.










 AI2 años ago
 Nano2 años ago

 AI11 meses ago

 AI2 años ago