

¡ADN ‘Basura’ No Tan Basura: El Tesoro Oculto del Genoma Humano!
-

Grandes bancos de EE.UU. arman una red conjunta de depósitos tokenizados
-

Augustus, una fintech que construye un banco de compensación con carta federal en USA
-

Aptos apuesta USD $50 millones a la AI y los mercados institucionales on-chain
-

Binance Lanza la Agentic Wallet: La Era de las Carteras Diseñadas para Agentes de IA

¿Qué es el ADN «Basura» y Cuánto Representa?
El genoma humano tiene unos 3.200 millones de pares de bases, pero solo el 1-2% codifica proteínas, es decir, los genes que producen las moléculas esenciales para la vida. Esto deja un asombroso 98-99% como ADN no codificante, apodado «ADN basura» desde 1972, cuando Susumu Ohno sugirió que era un residuo inútil. ¡Pero espera! Investigaciones recientes revelan que este vasto océano genético esconde tesoros cruciales para nuestra biología, desafiando la idea de que es simple «basura».
¿Qué funciones tiene?
- Regula la expresión génica mediante regiones como potenciadores y silenciadores.
- Produce ARN no codificante, como microARNs, que controlan la actividad de los genes.
- Protege los cromosomas, como los telómeros, y ayuda en la evolución humana, con secuencias como los transposones.
- Estudios recientes, como uno de 2023 de Stanford Medicine , muestran que cambios en estas regiones están ligados a enfermedades como el autismo y el cáncer.
¿Cómo afecta a la salud?
Parece que variaciones en el ADN no codificante pueden causar o influir en enfermedades. Por ejemplo, un estudio de 2024 del NIHR Oxford
encontró que estas variaciones cambiaron diagnósticos en pacientes con condiciones raras, incluso salvando vidas en algunos casos.
Nota Detallada
El término «ADN basura» (o «junk DNA» en inglés) se refiere a las regiones del genoma humano que no codifican proteínas, constituyendo aproximadamente el 98-99% de los 3.200 millones de pares de bases del genoma. Históricamente, se pensaba que estas secuencias eran residuos evolutivos sin función, pero investigaciones recientes han desafiado esta noción, mostrando que gran parte del ADN no codificante tiene roles cruciales en la regulación genética, la evolución y la biología humana. A continuación, se presenta un análisis detallado basado en estudios actualizados hasta junio de 2025.
Contexto Histórico y Definición
El concepto de «ADN basura» se formalizó en 1972 por Susumu Ohno, quien sugirió que estas secuencias no codificantes se acumulaban pasivamente sin propósito. Sin embargo, desde entonces, la investigación ha revelado que muchas de estas regiones son biológicamente activas. Por ejemplo, el proyecto ENCODE, iniciado en 2003 y con actualizaciones hasta 2012, encontró que cerca del 80% del genoma humano muestra actividad bioquímica, como la unión de proteínas o la transcripción en ARN, lo que sugiere funciones reguladoras
. A pesar de esto, persiste el debate: algunos científicos, como Dan Graur, argumentan que menos del 25% del genoma tiene función preservada, mientras que otros, como el equipo de ENCODE, consideran que la mayoría es funcional.
Funciones del ADN No Codificante en Humanos
El ADN no codificante desempeña múltiples roles, que incluyen:
- Regulación Génica: Contiene elementos como promotores, potenciadores (enhancers) y silencadores que controlan la expresión génica. Por ejemplo, los potenciadores pueden aumentar la actividad de genes en tejidos específicos, como el cerebro o el corazón.
- ARN No Codificante: Estas regiones producen moléculas como microARNs (miRNAs) y ARN largos no codificantes (lncRNAs). Los miRNAs regulan la expresión génica al silenciar genes específicos, mientras que los lncRNAs influyen en la estructura de la cromatina y la transcripción, siendo cruciales en procesos como el desarrollo celular y la respuesta inmune.
- Estructura y Protección: Los telómeros, secuencias repetitivas no codificantes en los extremos de los cromosomas, protegen el ADN de la degradación, lo que es esencial para la longevidad celular y la prevención del envejecimiento prematuro. Los centrómeros, también ricos en ADN no codificante, aseguran la correcta división celular durante la mitosis.
- Evolución Humana: Secuencias como los transposones, que constituyen alrededor del 50% del genoma humano, han sido fundamentales en la evolución. Estos «genes saltarines» pueden hacer copias de sí mismos e insertarse en nuevas ubicaciones, influyendo en la diversidad genética. Un estudio de 2023 del Instituto de Biología Evolutiva (IBE) identificó cientos de miles de regiones no codificantes conservadas en humanos y primates, esenciales para rasgos únicos como la complejidad del cerebro humano.
- Pseudogenes: Aunque a menudo considerados no funcionales, algunos pseudogenes, como PTENP1 (descubierto en 2010), regulan la actividad de genes originales, influyendo en procesos como el crecimiento tumoral.
Hallazgos Recientes y Su Impacto en la Salud
Investigaciones recientes han destacado el papel del ADN no codificante en enfermedades y diagnósticos:
- Stanford Medicine (2023): Un estudio liderado por investigadores de Stanford descubrió que las repeticiones en tándem cortas (STRs), que componen aproximadamente el 5% del genoma humano, influyen significativamente en la expresión génica. Cambios en estas STRs están ligados a enfermedades como el autismo, la esquizofrenia, el cáncer y la enfermedad de Crohn. Se encontró que los STRs alrededor de los motivos de factores de transcripción pueden alterar la unión de estos factores hasta en un 70%, afectando la expresión génica y el riesgo de enfermedad. Este trabajo, publicado en Science , desarrolló modelos a partir de más de 6.000 experimentos, aplicables al paisaje regulatorio completo, ayudando a entender cómo estas variaciones contribuyen al progreso de enfermedades.
- NIHR Oxford Biomedical Research Centre (2024): En un estudio con 122 pacientes con condiciones genéticas raras, como arritmias cardíacas, inflamación cerebral, enfermedad inflamatoria intestinal y anomalías renales, se encontró que variantes en el ADN no codificante eran significativas en varios casos. Se identificaron cinco genes nuevos y se sospechó que otros tres causaban condiciones raras. Esto llevó a cambios en los diagnósticos clínicos de seis pacientes y ajustes en los tratamientos de ocho, con intervenciones consideradas vitales para cinco pacientes. Este trabajo, publicado en Genomic Medicine , también contribuyó a las guías del NHS sobre el uso de genómica, destacando la necesidad de analizar todo el genoma, no solo las regiones codificantes, para maximizar el rendimiento diagnóstico.
- Quanta Magazine (2021): Aunque no es un estudio reciente, proporciona un contexto sobre la complejidad del ADN no codificante, destacando que, aunque solo el 2% del genoma codifica proteínas, el resto incluye elementos funcionales como ARNs no codificantes, transposones y pseudogenes, con roles en la regulación, la evolución y la respuesta a enfermedades. Este artículo también menciona ejemplos como ERVW-1, un retrovirus integrado hace 25 millones de años, esencial para el desarrollo de la placenta humana.
Controversias y Debates
A pesar de estos avances, persiste el debate sobre cuánto del ADN no codificante es realmente funcional. Un estudio de 2017 en New Scientist sugirió que al menos el 75% del ADN humano podría ser «basura», basándose en argumentos evolutivos sobre tasas de mutación y reproducción, contradiciendo afirmaciones de ENCODE. Por otro lado, investigadores como Zhaolei Zhang y Cristina Sisu, citados en el artículo de Quanta Magazine, consideran que estamos en una «edad dorada» para entender los roles del ADN no codificante, y el término «ADN basura» está cayendo en desuso, promoviendo una evaluación más abierta.
Tabla Resumen de Hallazgos Recientes
| Estudio | Año | Hallazgo Principal | Impacto en Salud |
|---|---|---|---|
| Stanford Medicine | 2023 | STRs influyen en expresión génica, ligadas a autismo, cáncer, etc. | Modelos para entender riesgo de enfermedad, avances en investigación. |
| NIHR Oxford Biomedical Research | 2024 | Variantes no codificantes cambiaron diagnósticos en pacientes con condiciones raras. | Diagnósticos mejorados, tratamientos ajustados, guías NHS. |
| Quanta Magazine (contexto) | 2021 | ADN no codificante incluye ARNs funcionales, transposones, roles en evolución. | Base para estudios en regulación y enfermedades. |
Perspectiva Actual y Futuro
La investigación actual se centra en desentrañar cómo las variaciones en el ADN no codificante influyen en la expresión génica y contribuyen a enfermedades, lo que ha llevado a avances en diagnósticos y tratamientos. Métodos de secuenciación mejorados, como los utilizados en los estudios mencionados, están facilitando esta comprensión. Sin embargo, dado el debate sobre su funcionalidad, parece probable que no todo el ADN no codificante tenga un propósito claro, y parte podría ser ruido evolutivo. Esto refleja la complejidad del genoma humano y la necesidad de seguir investigando.
En conclusión, el ADN «basura» en humanos no es tan inútil como se pensaba. Regula genes, produce ARN funcional, protege cromosomas y ha moldeado nuestra evolución. Su papel en enfermedades y diagnósticos es cada vez más evidente, con estudios recientes mostrando su impacto directo en la salud humana. Sin embargo, el debate sobre su funcionalidad sigue abierto, y la investigación futura probablemente aclarará aún más su importancia.
Key Citations



Un sistema de edición genética busca ampliar las opciones frente a CRISPR

Una proteína humana diseñada abre nuevas vías para editar ARN

Nanomedicina investiga materiales renovables para administrar fármacos

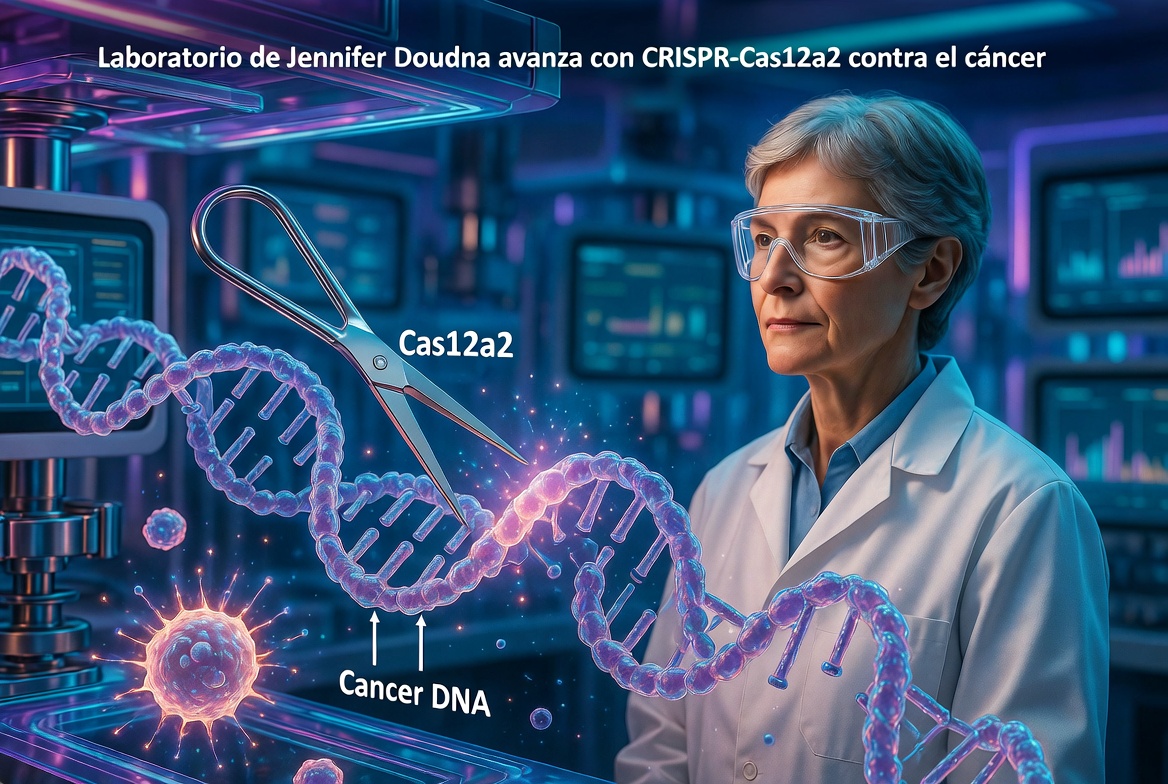
CRISPR Parte I: Avances en Terapias Génicas con CRISPR para 2025 – Transformando la Medicina

Vercel: La Plataforma Líder en Desarrollo Web y AI Cloud

¡El Futuro es Ahora! Los Avances Más Impactantes en Hologramas para 2025
Grandes bancos de EE.UU. arman una red conjunta de depósitos tokenizados
Augustus, una fintech que construye un banco de compensación con carta federal en USA
Aptos apuesta USD $50 millones a la AI y los mercados institucionales on-chain
-
 Bio1 año ago
CRISPR Parte I: Avances en Terapias Génicas con CRISPR para 2025 – Transformando la Medicina
-
 EmpresasTech10 meses ago
Vercel: La Plataforma Líder en Desarrollo Web y AI Cloud
-
 Researchland1 año ago
¡El Futuro es Ahora! Los Avances Más Impactantes en Hologramas para 2025
-
 AI1 año ago
¿Qué es Hugging Face? Guía Actualizada a Mayo 2025
-
 Nano2 años ago
Las últimas innovaciones en nanotecnología
-

 AI11 meses ago
Google Antigravity: La Herramienta IA Multiagentes que Revoluciona el Desarrollo de Software
-

 AI2 años ago
Agentes de IA y Workflows Agénticos: La Revolución de la Automatización
-
 AI2 años ago
Agentes de IA vs. Agentic AI : Diferencias, Ejemplos y Avances Recientes