La computadora del futuro está viva: neuronas humanas que reemplazan los chips de silicio
Biocomputación, wetware e inteligencia artificial orgánica — el estado del arte en 2026
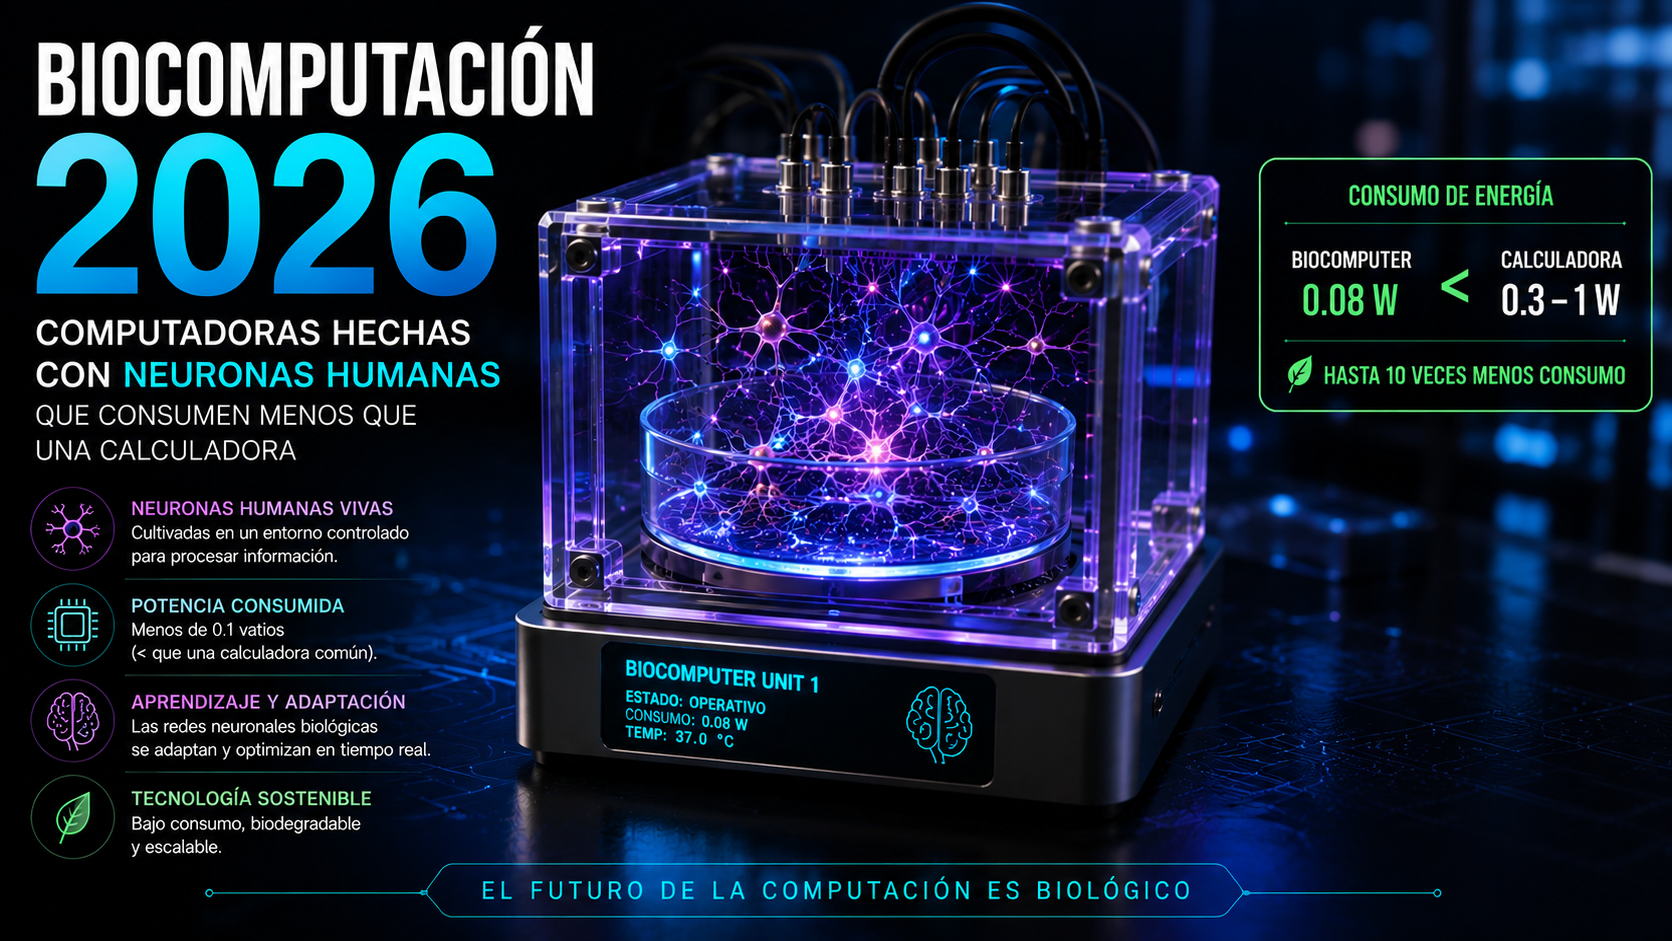
Una computadora hecha con células del cerebro humano ya existe, se vende, corre videojuegos y va a alimentar centros de datos. Consume menos energía que una calculadora de escritorio. Esto no es ciencia ficción: es lo que está pasando ahora mismo.
30 WConsumo del CL1 (vs. 600 W de una GPU de IA)
800kNeuronas humanas por unidad CL1
$35kPrecio de la primera biocomputadora comercial
¿Qué es la biocomputación? La idea en términos simples
Una computadora convencional procesa información usando transistores: pequeños interruptores de silicio que se encienden y apagan miles de millones de veces por segundo. La biocomputación propone hacer lo mismo pero usando neuronas vivas, las mismas células que forman el cerebro humano.
Una analogía sencilla: imaginá que en vez de usar un teclado mecánico para escribir, usás los dedos directamente sobre la pantalla. La información pasa igual, pero el mecanismo es completamente diferente, más fluido, más adaptable. La biocomputadora hace algo parecido: en vez de transistores rígidos, usa neuronas que aprenden y se modifican solas.
El campo también se conoce como wetware —en contraposición al hardware (los chips) y el software (los programas)— o como «inteligencia organoide». Las neuronas se cultivan en laboratorio a partir de células madre humanas, se depositan sobre un chip de silicio con microelectrodos y se les manda información en forma de pulsos eléctricos. La red neuronal responde, aprende y genera una salida que el sistema digital puede leer e interpretar.
La parte clave: estas neuronas no solo ejecutan instrucciones fijas. Se reorganizan solas, aprenden de la experiencia y se adaptan, exactamente igual que lo hace el cerebro. Eso es algo que ningún chip de silicio puede hacer de manera nativa.
El problema de la energía: por qué importa tanto
Para entender el atractivo de la biocomputación hay que entender primero la crisis energética de la inteligencia artificial. Entrenar un modelo grande de lenguaje como GPT-4 consume una cantidad de energía equivalente a la que usa un hogar durante décadas. Los centros de datos de IA ya consumen más electricidad que países enteros, y la situación empeora cada año.
La Agencia Internacional de Energía proyectó que el consumo eléctrico de los centros de datos podría duplicarse para 2026, impulsado en gran parte por la IA. Una sola consulta a ChatGPT consume alrededor de diez veces más energía que una búsqueda en Google.
Comparación de consumo energético
Cerebro humano
20 W
CL1 (Cortical Labs)
30 W
GPU Gaming (RTX 4090)
450 W
GPU de IA (H100)
700 W
Rack completo de IA
>100 kW
El cerebro humano realiza cálculos equivalentes a exaflops (un trillón de operaciones por segundo) con apenas 20 vatios. Una GPU de IA consume entre 300 y 700 vatios y necesita refrigeración adicional. La diferencia en eficiencia no es de dos o tres veces: es de órdenes de magnitud. FinalSpark afirma que su plataforma de biocomputación puede ser hasta mil millones de veces más eficiente energéticamente que el hardware de silicio tradicional para ciertos tipos de tareas de aprendizaje.
Para dimensionarlo: si una GPU de IA fuera un camión de carga, el cerebro —y por extensión, la biocomputadora— sería una bicicleta. Llevan la misma información. Pero una necesita autopistas, combustible y mantenimiento constante, y la otra casi nada.
Cómo funciona por dentro: la arquitectura del wetware
El sistema tiene cuatro componentes básicos que trabajan juntos:
1. Las neuronas cultivadas
Se toman células madre (generalmente de sangre humana) y se reprograman para convertirlas en neuronas. Estas células se depositan sobre un chip de silicio y comienzan a crecer, extendiendo sus ramificaciones y formando conexiones entre sí, igual que en un cerebro real. En el CL1 de Cortical Labs, por ejemplo, hay alrededor de 800.000 neuronas por unidad.
2. Los microelectrodos (MEA)
Debajo de las neuronas hay una grilla de electrodos microscópicos. Estos electrodos son los «puertos de comunicación»: envían pulsos eléctricos a las neuronas (así les mandan datos) y leen su respuesta eléctrica (así reciben los resultados). Es la interfaz entre el mundo digital y el biológico.
3. El sistema de soporte vital
Las neuronas necesitan vivir. El dispositivo incluye un sistema de temperatura controlada, circulación de nutrientes, filtración y mezcla de gases que mantiene a las células vivas durante meses. El CL1 puede mantener sus neuronas activas hasta seis meses.
4. El aprendizaje biológico
Aquí está la magia: las neuronas aprenden siguiendo los mismos principios que el cerebro humano. La idea central es la plasticidad sináptica, que se resume en una frase clásica de la neurociencia: «neuronas que se disparan juntas, se conectan juntas.» No hay que programar reglas: la red neuronal se autoorganiza en respuesta a los estímulos.
Las empresas que están liderando este campo
Cortical Labs
🇦🇺 Melbourne, Australia
La más avanzada comercialmente
Fundada en 2019, hicieron historia en 2022 cuando sus neuronas aprendieron a jugar al Pong (el videojuego de 1972). En marzo de 2025 lanzaron el CL1, la primera biocomputadora comercial del mundo, a $35.000 la unidad.
En febrero de 2026 entrenaron sus neuronas para jugar al DOOM. En marzo de 2026 abrieron un mini centro de datos biológico en Melbourne con 120 unidades CL1.
FinalSpark
🇨🇭 Vevey, Suiza
Pioneros en la nube
Creadores de la Neuroplatform, la primera plataforma de biocomputación en la nube del mundo. Permite a investigadores de cualquier país acceder a organoides cerebrales humanos de manera remota para hacer experimentos.
Sus organoides tienen decenas de miles de neuronas y se mantienen en ambientes microfluídicos que les proveen nutrientes continuamente.
También hay otros actores relevantes: System1 Biosciences recaudó 25 millones de dólares para usar organoides cerebrales en el descubrimiento de terapias para enfermedades como la epilepsia y el autismo. El Departamento de Defensa de Estados Unidos también expresó interés en biocomputación para aplicaciones donde el consumo energético es crítico, como en drones y sistemas de campo.
Los últimos logros: de Pong a data centers biológicos
2022
DishBrain juega al Pong. Cortical Labs demuestra que neuronas humanas y de ratón en un chip pueden aprender a jugar un videojuego en tiempo real usando retroalimentación eléctrica. El paper se publica en la revista Neuron y causa sensación en la comunidad científica.
Mayo 2024
FinalSpark publica su Neuroplatform. La primera plataforma abierta y accesible remotamente para investigación en wetware computing. Investigadores de todo el mundo pueden conectarse y experimentar con organoides cerebrales humanos sin necesidad de laboratorio propio.
Marzo 2025
Nace el CL1. Cortical Labs presenta en el MWC 2025 la primera biocomputadora comercial del mundo. Precio: $35.000. Incluye soporte vital integrado, 800.000 neuronas cultivadas de células madre humanas y un sistema operativo biológico (biOS). También se ofrece en modalidad cloud como «Wetware-as-a-Service».
Septiembre 2025
Primer rack de CL1s en funcionamiento. Cortical Labs monta varios racks de unidades CL1 conectadas a internet para probar el sistema a mayor escala. Arranca el servicio Cortical Cloud.
Febrero 2026
Las neuronas juegan al DOOM. Un hito inesperado: Cortical Labs muestra en video cómo su CL1 —con 800.000 neuronas cultivadas— aprende a jugar el icónico juego de disparos en primera persona. La demostración prueba una capacidad de procesamiento de información mucho más compleja que el Pong.
Marzo 2026
Los primeros centros de datos biológicos del mundo. Cortical Labs anuncia en sociedad con DayOne Data Centers la apertura de un centro de datos biológico en Melbourne (120 unidades CL1) y otro en marcha en Singapur, que planea escalar a 1.000 unidades CL1 hacia septiembre de 2026. Es el primer intento serio de usar wetware a escala de infraestructura real.
El CL1 consume solo 30 vatios por unidad, frente a los 600 vatios de una GPU de IA tradicional. Los centros de datos biológicos de Cortical Labs prometen requerir «una fracción de la energía» de los centros de datos convencionales, además de eliminar el uso intensivo de agua para refrigeración.
Qué puede y qué no puede (todavía) hacer el wetware
Sus puntos fuertes
Eficiencia energética radical. Ya mencionada: consume órdenes de magnitud menos energía que el silicio para tareas de aprendizaje adaptativo.
Aprende con pocos datos. Los sistemas de IA convencionales necesitan millones de ejemplos para aprender algo. El wetware, como el cerebro, puede aprender de forma eficiente con conjuntos de datos mucho más pequeños.
Ideal para entornos inciertos. Las neuronas son naturalmente buenas manejando ambigüedad, variabilidad y situaciones nuevas, algo en lo que los sistemas digitales siguen fallando.
Investigación médica sin animales. Cortical Labs destaca que el CL1 permite hacer investigación de fármacos y enfermedades neurológicas directamente sobre tejido humano, sin necesidad de experimentos en animales.
Sus limitaciones actuales
Escala. El cerebro humano tiene entre 60.000 y 99.000 millones de neuronas. El CL1 tiene 800.000. La distancia es enorme. No hay un camino claro todavía para escalar biológicamente de forma masiva.
Velocidad bruta. Las neuronas procesan en milisegundos; los transistores, en nanosegundos. Para tareas que requieren velocidad de reloj extrema, las GPUs siguen ganando.
Reproducibilidad. Los sistemas biológicos son variables por naturaleza. Dos organoides del mismo origen pueden comportarse de forma diferente, lo que complica la estandarización.
Mantenimiento. Mantener vivas las neuronas requiere temperatura, nutrientes y esterilidad constantes. Escalar eso a nivel de centro de datos es un desafío de ingeniería sin precedentes.
El tema más perturbador: las «células personales»
⚗️ El escenario más inquietante del campo
«¿Qué significa tener una parte de tu cerebro computando fuera de tu cuerpo?»
La tecnología ya existe para tomar células de la sangre de una persona, convertirlas en células madre y luego en neuronas funcionales. Técnicamente sería posible crear una biocomputadora hecha con el material genético de una persona específica: una computadora que, en cierto sentido, sería una extensión biológica de esa persona.
Esto plantea preguntas sin respuesta: ¿quién sería el dueño de ese organoide? ¿Podría usarse para replicar aspectos de la personalidad o los patrones cognitivos del individuo? ¿Qué pasa si esas células son usadas para fines no consentidos? ¿Cuáles son los derechos de esa entidad si desarrollara alguna forma de experiencia subjetiva?
Hoy por hoy, los sistemas son demasiado simples como para plantear estas preguntas de forma urgente. Pero los expertos coinciden en que hay que tenerlas sobre la mesa antes de que la tecnología las vuelva apremiantes.
La cuestión de la consciencia
Cortical Labs habló de «sentience» (sensibilidad) al describir el DishBrain en 2022, lo que generó críticas en la comunidad científica. Investigadores de Johns Hopkins y otras instituciones advirtieron en noviembre de 2025 que términos como «inteligencia organoide» pueden crear expectativas infladas y generar un backlash que frene el campo antes de que madure. El consenso científico actual es claro: los organoides existentes muestran una capacidad rudimentaria de respuesta y adaptación, pero nada que se acerque a la consciencia o cognición superior.
El vacío regulatorio
No existe ningún marco regulatorio global o nacional que se ocupe específicamente de la biocomputación. La velocidad del avance científico supera ampliamente la capacidad legislativa. Investigadores de todo el mundo firmaron la Declaración de Baltimore (2023) llamando a la comunidad científica a explorar este campo con responsabilidad, pero aún falta construir las instituciones que hagan cumplir esas intenciones.
Qué se espera para los próximos años
El horizonte inmediato está bastante definido. Para el segundo semestre de 2026, Cortical Labs planea escalar su centro de datos de Singapur a 1.000 unidades CL1, en lo que sería la mayor instalación de wetware computing del mundo. En paralelo, su servicio en la nube (Cortical Cloud) estará disponible para investigadores globales, democratizando el acceso a la tecnología.
FinalSpark continúa extendiendo la vida útil de sus organoides y mejorando la generación de los mismos, según sus propias actualizaciones. Un equipo de la Universidad de Bristol ya publicó investigación basada en experimentos conducidos en la Neuroplatform de FinalSpark, señal de que la plataforma está siendo adoptada por la academia.
Un equipo de la Universidad de California en San Diego propuso usar sistemas basados en organoides para predecir trayectorias de derrames de petróleo en el Amazonas para 2028, lo que sugiere que los investigadores empiezan a imaginar aplicaciones concretas más allá del laboratorio.
A más largo plazo, los expertos del campo no ven al wetware como un reemplazo del silicio sino como un complemento para tareas específicas: sistemas de IA embebidos en robots o drones que necesitan operar en el mundo real con restricciones energéticas severas, modelado de enfermedades neurológicas, y eventualmente, sistemas híbridos que combinen la velocidad del silicio con la eficiencia y adaptabilidad del tejido neuronal.
La biocomputación está exactamente donde estaba la computación digital en los años 40: prometedora, rudimentaria, llena de problemas de escala no resueltos y con un enorme potencial a largo plazo. El ENIAC llenaba una habitación entera y apenas podía sumar. Hoy el mundo cabe en un chip. La pregunta no es si la biocomputación va a importar, sino cuándo.
Fuentes y lecturas recomendadas
- Kagan et al. (2022). In vitro neurons learn and exhibit sentience when embodied in a simulated game-world. Neuron. — El paper original del DishBrain jugando al Pong. cell.com/neuron
- FinalSpark — Neuroplatform: la primera plataforma de biocomputación en la nube. finalspark.com/neuroplatform
- FinalSpark — Publicaciones y actualizaciones técnicas del equipo. finalspark.com/articles
- Jordan et al. (2024). Open and remotely accessible Neuroplatform for research in wetware computing. Frontiers in AI. ncbi.nlm.nih.gov/pmc/articles/PMC11097343
- Cortical Labs — CL1, la primera biocomputadora comercial del mundo. corticallabs.com
- IEEE Spectrum (2025). Biological Computer for Sale. spectrum.ieee.org/biological-computer-for-sale
- Gizmodo (marzo 2026). The Company That Made a Dish of Neurons Play DOOM Is Getting Into Brain Cell-Powered Data Centers. gizmodo.com
- Tom’s Hardware (marzo 2026). Human brain cells set to power two new data centers. tomshardware.com
- Data Center Dynamics (marzo 2026). Cortical Labs unveils biological data center prototype. datacenterdynamics.com
- Information Age / ACS (marzo 2026). This Melbourne data centre runs on human brain cells. ia.acs.org.au
- Singularity Hub (diciembre 2025). How Scientists Are Growing Computers From Human Brain Cells. singularityhub.com
- STAT News (noviembre 2025). Brain organoid pioneers fear inflated claims about biocomputing could backfire. statnews.com
- Frontiers in Science (2023). Organoid intelligence (OI): the new frontier in biocomputing. frontiersin.org
- Springer Nature (diciembre 2025). From Brain Organoids to Organoid Intelligence: Benefits and Ethical-Moral Framework. link.springer.com
Nota elaborada con fuentes verificadas al 10 de mayo de 2026 · Biocomputación / Wetware / Inteligencia Artificial Orgánica









 AI1 año ago
 Nano2 años ago

 AI11 meses ago

 AI2 años ago