El agente AI que crece con vos. Open source, gratis, corre en tu servidor.
¿Qué es Hermes Agent?
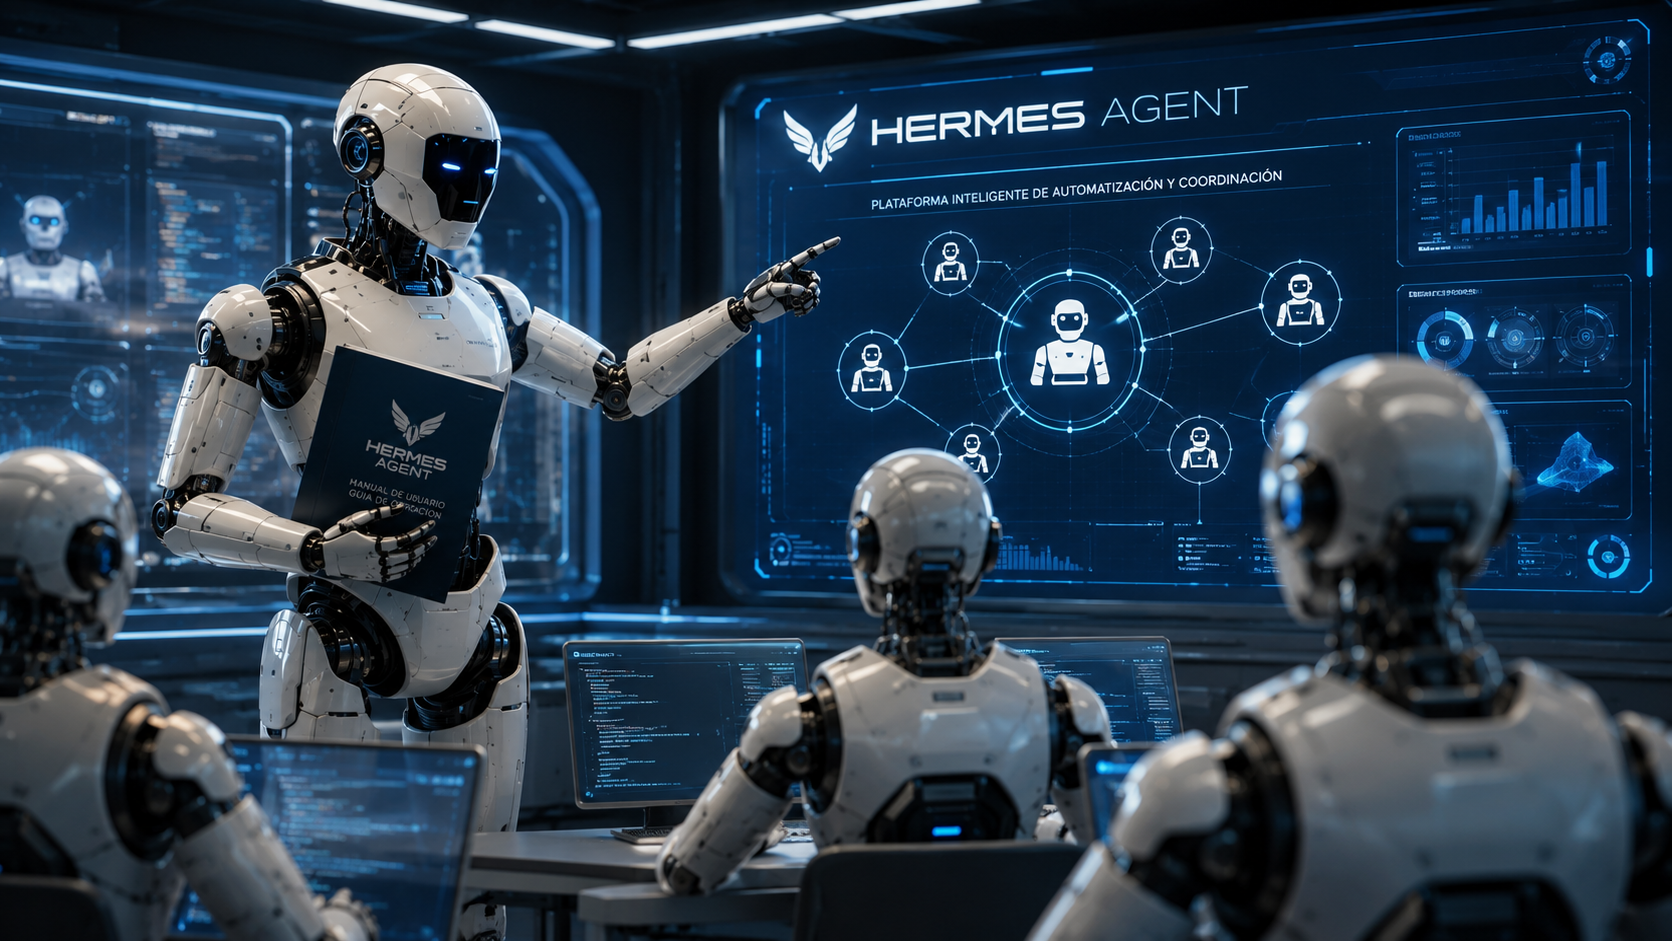
Hermes Agent es un agente de inteligencia artificial de código abierto creado por Nous Research. Se lanzó en febrero de 2026 y en menos de tres meses superó los 140.000 estrellas en GitHub, convirtiéndose en uno de los agentes AI más usados del mundo.
A diferencia de un chatbot normal, Hermes no olvida nada cuando cerrás la sesión. Vive en tu servidor, recuerda lo que aprende y se vuelve más capaz cuanto más lo usás. El eslogan del proyecto lo resume bien: «el agente que crece con vos».
La diferencia clave con otros agentes AI
Característica
Chatbot normal
Hermes Agent
Memoria entre sesiones
No
Sí, permanente
Aprende de cada tarea
No
Sí, crea Skills reutilizables
Corre en tu máquina
No (nube)
Sí, 100% local
Automatizaciones programadas
No
Sí, con lenguaje natural
Multi-agente (delega tareas)
No
Sí, sub-agentes paralelos
Controla el navegador
No
Sí
Costo del software
Suscripción mensual
Gratis (MIT License)
Conceptos clave antes de empezar
Skills (Habilidades) Cuando Hermes resuelve una tarea compleja, automáticamente escribe un documento llamado Skill que captura cómo lo hizo, qué funcionó y qué errores evitar. La próxima vez que aparezca una tarea similar, usa ese Skill en lugar de razonar desde cero. Cuanto más lo usás, más rápido y preciso se vuelve.
Memoria persistente Todo lo que Hermes aprende se guarda en tu máquina, en la carpeta ~/.hermes/. Incluye tus preferencias, historial de proyectos, Skills generados y tu modelo de usuario.
El loop de aprendizaje
Recibe un objetivo y lo descompone en pasos
Evalúa si el resultado fue exitoso
Si la tarea fue compleja y exitosa, crea un Skill reutilizable
Actualiza los Skills cuando descubre mejores enfoques
En tareas futuras similares, aplica el Skill relevante
Gateway de mensajería Un proceso que conecta a Hermes con tus plataformas de mensajería. Podés chatear con él desde Telegram, Discord, Slack, WhatsApp, Signal o la terminal, y el contexto se mantiene entre todas las plataformas.
Instalación
Hermes soporta Linux, macOS y Windows (via WSL2). No requiere ningún prerequisito: el script los instala todos solos.
Eso es todo. El script instala Python 3.11, clona el repositorio y agrega el comando hermes a tu PATH. Tarda menos de 60 segundos.
Windows
Opción recomendada: instalá WSL2 primero.
Abrí PowerShell como Administrador
Ejecutá: wsl --install
Reiniciá la PC
Abrí Ubuntu desde el menú inicio
Seguí las instrucciones de Linux de arriba
Nota: Windows nativo tiene soporte experimental. Para uso serio, usá WSL2.
Verificar la instalación
hermes --version
Si el comando no se reconoce, cerrá y volvé a abrir la terminal.
Configuración inicial
Una vez instalado, configurá el modelo de lenguaje que va a usar Hermes:
hermes setup
Esto abre un asistente interactivo donde elegís tu proveedor de modelo.
Opciones de modelo disponibles
Proveedor
Cómo acceder
Ideal para
Nous Portal
Login con Google (OAuth)
Empezar rápido, sin configurar nada
OpenRouter
API Key
Acceso a 200+ modelos
OpenAI
API Key de openai.com
Usuarios ya con cuenta OpenAI
Anthropic
API Key de anthropic.com
Razonamiento de alta calidad
Ollama (local)
Instalación local
100% privado, sin internet
vLLM / custom
Endpoint propio
Equipos técnicos avanzados
Primera vez: usá Nous Portal. Solo hacés login con Google y ya está.
Cambiar el modelo en cualquier momento
hermes model
Modo 100% local con Ollama (sin enviar nada a servidores externos)
# 1. Instalar Ollama
curl -fsSL https://ollama.ai/install.sh | sh

# 2. Descargar un modelo
ollama pull llama3.1:8b

# 3. Iniciar Ollama
ollama serve

# 4. Configurar Hermes (hermes model → Custom API → http://localhost:11434/v1)
Nota: los modelos locales requieren al menos 8GB de RAM. Se recomiendan 16GB o más.
Uso básico
Para abrir el chat interactivo:
hermes
Escribís tu pedido en lenguaje natural y Hermes lo ejecuta. Ejemplos:
«Buscá las últimas noticias sobre inteligencia artificial y haceme un resumen.»
«Escribí un script Python que lea un CSV y genere un gráfico de barras.»
«Corregí la gramática y el estilo de este texto.»
«Programá un backup diario de la carpeta /datos a las 3 AM.»
«Mandame un email a juan@empresa.com con el resumen de la reunión de hoy.»
Entornos de ejecución de código
Cuando Hermes necesita correr código, lo hace en un entorno aislado (sandbox). Tenés cinco opciones:
Backend
Cuándo usarlo
Local
Acceso directo a tus archivos
Docker
Aislamiento de seguridad (recomendado para uso diario)
SSH
Delegar carga a otra máquina remota
Modal
Escalar en la nube sin servidor propio
Singularity
Clusters HPC / entornos científicos
Conectar Telegram, Discord, WhatsApp y más
Configurar el gateway
hermes gateway setup
El asistente interactivo te guía para conectar cada plataforma.
Cómo conectar Telegram (la opción más simple)
Abrí Telegram y buscá @BotFather
Escribí /newbot y seguí las instrucciones
BotFather te da un token (algo como 123456:ABC-DEF...)
En el setup de Hermes, pegá ese token cuando te lo pida
Iniciá una conversación con tu nuevo bot en Telegram
Iniciar el gateway
hermes gateway
Instalarlo como servicio (se inicia solo al bootear el servidor)
hermes gateway install
Una vez configurado, podés iniciar una conversación en Telegram, continuarla en Discord y terminarla en la terminal. Hermes mantiene el contexto de todo.
Los mensajes de voz se transcriben automáticamente, sin configuración extra.
Automatizaciones y tareas programadas
Hermes tiene un scheduler incorporado que acepta lenguaje natural. No hace falta escribir expresiones cron.
Simplemente escribís en el chat:
«Mandame un resumen de noticias tecnológicas todos los días a las 8 AM por Telegram.»
«Hacé un backup de la carpeta /proyectos todos los viernes a las 10 PM.»
«Revisá el servidor y mandame un informe de estado todos los lunes a las 9 AM.»
«Generá un reporte de ventas mensual el último día de cada mes.»
Gestionar automatizaciones
Para ver las activas:
¿Qué automatizaciones tengo activas? (escribís esto en el chat de Hermes)
Para cancelar una:
Cancelá el backup del viernes.
Las automatizaciones corren a través del proceso del gateway. Si lo instalaste como servicio del sistema, se ejecutan aunque no tengas ninguna terminal abierta.
El sistema de Skills
Ver tus Skills
Preguntale en el chat: «¿Qué skills tenés guardados?»
O explorá manualmente en: ~/.hermes/skills/
Skills de la comunidad
Existe una comunidad que comparte Skills en agentskills.io. Para instalar uno:
Instalá el skill de análisis de CSV de agentskills.io (en el chat de Hermes)
Los Skills son archivos de texto en formato SKILL.md. Podés leerlos, editarlos y crear los tuyos propios.
Skills incorporados (40+)
Hermes viene con más de 40 Skills preinstalados: GitHub (PRs, issues, commits), MLOps (entrenar modelos, generar datasets), diagramas, notas y muchos más disponibles en la comunidad.
Actualizar Skills
hermes update
Multi-agente: coordinar equipos de agentes
Hermes puede actuar como coordinador y delegar tareas a sub-agentes que corren en paralelo. Cada sub-agente tiene su propio contexto, terminal y Skills.
Ejemplo práctico: si tenés que procesar 100 documentos, Hermes puede crear 10 sub-agentes en paralelo, asignar 10 documentos a cada uno, y combinar los resultados al final. Esto reduce el tiempo de proceso dramáticamente y no consume el contexto del agente principal.
Hermes también puede enrutar distintas sub-tareas al modelo más adecuado. Por ejemplo, usar Claude Opus para análisis complejos y un modelo local para tareas sensibles que no deben salir de tu red.
Capacidades web y de visión
Incluido de fábrica, sin configuración extra:
Capacidad
Qué puede hacer
Búsqueda web
Buscar información actualizada en internet
Extracción de páginas
Leer y analizar el contenido de cualquier URL
Automatización de navegador
Navegar, hacer clic, completar formularios
Screenshots
Capturar pantallas de páginas web
Análisis de imágenes
Describir, analizar y extraer info de imágenes
Generación de imágenes
Crear imágenes con prompts de texto
Text-to-Speech
Convertir texto en audio
Ejemplo de lo que podés pedir: «Entrá a mi panel de admin, buscá todos los pedidos de hoy y exportalos a un CSV.»
Seguridad y privacidad
Característica
Detalle
Sin telemetría
Cero datos enviados a Nous Research ni terceros
Sin tracking
No registra tus conversaciones en servidores externos
Datos locales
Todo se guarda en ~/.hermes/ en tu máquina
Container hardening
Root de solo lectura, capacidades reducidas
MIT License
Podés auditar cada línea de código
Sin lock-in
Cambiás de modelo o proveedor cuando querés
Para entornos regulados (HIPAA, CMMC, etc.): combiná Hermes con Ollama para que absolutamente ningún dato salga de tu red.
Opciones de hospedaje gestionado
Si no querés encargarte del servidor, existen opciones donde todo viene listo:
OpenHosst — desde USD $2.99/mes, prueba gratuita de 7 días sin tarjeta. Hermes preinstalado y configurado. portal.openhosst.com
NVIDIA RTX / DGX Spark — para usuarios con hardware NVIDIA que quieren máximo rendimiento on-premise con aceleración GPU.
Petronella Technology Group — para organizaciones con requisitos de compliance (HIPAA, CMMC, SOC 2). Deployments desde USD $5.000.
Para uso personal y equipos pequeños, la opción self-hosted es completamente gratis. Solo pagás el servidor y las APIs de modelos que uses.
Casos de uso prácticos
Desarrolladores
Code reviews automáticos de PRs en GitHub
Generar tests unitarios para código existente
Documentar APIs y funciones automáticamente
Monitorear logs y notificar errores en Slack
Creadores de contenido
Briefing diario de noticias relevantes a tu nicho
Generar borradores de posts basados en tendencias
Investigar temas y crear resúmenes automáticamente
Operaciones y negocios
Reportes de ventas mensuales automáticos
Monitorear disponibilidad de servidores con alertas
Procesar y clasificar emails entrantes
Actualizar bases de datos con información de la web
Investigadores
Procesar miles de papers en paralelo con sub-agentes
Generar datasets de entrenamiento para fine-tuning
Exportar trayectorias en formato ShareGPT
Integración con Atropos para experimentos de RL
Solución de problemas comunes
El comando ‘hermes’ no se reconoce El PATH no se actualizó. Cerrá y volvé a abrir la terminal, o ejecutá: source ~/.bashrc
Error de API Key inválida Ejecutá hermes model y reingresá la API key.
Hermes no recuerda conversaciones anteriores Verificá que ~/.hermes/ existe y tiene permisos de escritura.
El gateway de mensajería no responde Ejecutá hermes gateway o verificá el servicio: systemctl status hermes-gateway
Modelo muy lento o sin respuesta Si usás un modelo local, probá uno más chico: ollama pull llama3.1:8b. O usá un proveedor cloud.
Error de Docker: permiso denegado Ejecutá sudo usermod -aG docker $USER y reiniciá sesión.
Camila Soria junto con SuperPioneros hicieron una presentación al respecto, Acá les presento un resumen de la misma junto al grupo Pioneros — la comunidad de Web3, IA e innovación liderada por José Luis Cáceres (CEO de NWC10, fundador de SuperPioneros y CBO de Bit2Me), que reúne a más de 80.000 personas aprendiendo, ayudando y construyendo juntas en el ecosistema. Los sigo hace años, y no es casualidad que este tema haya salido justo de ese espacio: son de los que están un paso adelante marcando por dónde va el debate técnico y legal de la industria en habla hispana.
La presentación de Camila Soria (CipherLaw)
Camila Soria es Chief Legal Architect en CipherLaw, estudio de Buenos Aires especializado en infraestructura legal estratégica para Web3 e IA. El material es la primera edición de «Legal Design for Builders», creada junto a NWC10 | SuperPioneros.
Su planteo, en sus propias palabras (post de LinkedIn que acompaña la presentación):
«Un agente puede tener permiso técnico para operar una wallet y, aun así, no tener autoridad para realizar cualquier operación.»
Durante la charla analizaron qué cambia cuando la IA deja de recomendar y empieza a decidir, firmar y ejecutar pagos. Su conclusión principal: los límites críticos no pueden vivir solamente en un prompt. El monto, la contraparte, la vigencia, las operaciones permitidas y la posibilidad de revocar el acceso tienen que formar parte de la arquitectura del sistema, no de una instrucción en lenguaje natural.
También plantea la necesidad de poder reconstruir la cadena completa — mandato → decisión → control → firma → ejecución — porque cuando algo sale mal, esa evidencia es lo que permite entender dónde ocurrió la falla y quién estaba en mejores condiciones de evitarla.
Las siete ideas centrales, en el orden del documento:
Del agente que habla al agente que paga: «Para el agente que habla, el derecho ya respondió. Para el que paga, recién empieza.»
«Autónomo» no significa lo mismo para todos: «Que vos definas el destino no significa que controles todo el camino.»
El regulador no mira solo el stack técnico: evalúa dominio, acción y derechos afectados — la combinación define el «perfil regulatorio».
Permiso no es lo mismo que autoridad: la autoridad real se define por monto, contraparte, vigencia y tipo de operación.
Quien razona no debería autorizar: «El agente puede razonar. No debería darse permiso a sí mismo.»
Un prompt no es un control: «Dale una llave de hotel, no una llave maestra.»
La responsabilidad sigue al control y al beneficio: como el agente no tiene patrimonio propio, la responsabilidad recae en quien controla el sistema y se beneficia de él.
Cierre su presentación y documento con lo siguiente, si construís agentes que actúan, también tenés que diseñar quién responde por sus acciones.
Fuente: Camila Soria (CipherLaw), presentación «Legal Design for Builders» — primera edición, creada junto a NWC10 | SuperPioneros, LinkedIn.
Mi visión adicional al documento de Camila (agregado, no parte del documento)
Hoy conviven dos modelos de agentes: unos con límite libre y otros con tarjetas prepagas recargables, con tope fijo controlado por un humano. Mastercard lanzó Agent Pay el 17 de septiembre de 2026 junto a Alchemy, donde el usuario define límites configurables: tope de gasto, categorías de comercio permitidas y geografías habilitadas, permitiendo que el agente compre sin pedir autorización en cada transacción, pero siempre dentro de esos parámetros. Fuente: Mastercard lanza Agent Pay con Alchemy — Ecosistema Startup
Si un agente se equivoca, el problema es de programación, no «de la IA»: conecta con el punto 5 del documento — un agente bien diseñado debería derivar a un humano antes de ejecutar una decisión compleja, en vez de resolverlo todo por sí solo.
El FSB (Consejo de Estabilidad Financiera) ya pide ese mismo control a nivel bancario: pidió que bancos limiten la IA agéntica y traten a los agentes como ‘empleados sintéticos’, con aval humano para transacciones por encima de ciertos montos. Fuente: Let’s Money — IA Agéntica
Argentina y la «Sociedad Automatizada»: el gobierno tiene en el Senado un proyecto de ley que introduce esta figura. Según el artículo 14, «la sociedad automatizada responde con su patrimonio frente a terceros por los daños causados por sus sistemas algorítmicos autónomos o agentes de inteligencia artificial». Fuente: Xataka — Milei quiere crear nueva categoría empresarial
Bots que se clonan si ganan y se apagan si pierden: conecta con una tendencia que recién empieza a circular en la industria, los «self-evolving agents». Vale aclarar que esto hoy es más una tendencia conceptual que algo funcionando en producción con dinero real. Fuente: Baguete — Vem aí os self-evolving agents
Mirada a futuro: avanzar, pero con cautela y por etapas (opinión propia)
Siguiendo el planteo de Camila Soria como base, mi lectura de hacia dónde debería ir esto es la siguiente: el futuro es avanzar, pero de forma gradual, no de golpe.
En una primera etapa, tiene sentido que los agentes de IA operen únicamente con tarjetas prepagas y topes bajos, sin manejar grandes volúmenes de dinero. No porque la tecnología no esté lista, sino porque el marco legal todavía no lo está — y como bien marca Soria, sin autoridad clara y sin control técnico real, cualquier volumen grande es un riesgo innecesario. Empezar chico, con montos acotados y recargables, permite que la industria (y la ley) vayan madurando al mismo ritmo que la tecnología, en vez de que la tecnología corra sola y la ley llegue tarde a poner orden.
Ahí es donde entra lo que estamos construyendo en AuriTrace.com: trazabilidad de lo que hacen los agentes de IA, siguiendo patrones que deben cumplirse, con la posibilidad de registrar esa información en una blockchain. Esto conecta directo con uno de los pedidos centrales de Camila Soria en el documento — poder reconstruir la cadena completa de mandato → decisión → control → firma → ejecución. Un registro en blockchain le da a esa cadena algo clave: evidencia inmutable y verificable, exactamente lo que hace falta cuando algo sale mal y hay que determinar quién estaba en mejores condiciones de evitar la falla.
En resumen: la tecnología para que los agentes paguen y actúen solos ya existe. Lo que falta madurar es el círculo completo — tope de gasto controlado por humanos, trazabilidad verificable de cada acción, y un marco legal claro sobre quién responde. Avanzando en ese orden, por etapas, se puede construir un ecosistema de agentes de IA confiable sin repetir errores que después sean difíciles de deshacer. Vos que opinás a la presentación de Camila?? cuales son tus sugerencias.. el futuro lo vamos construyendo entre todos.
OpenAI confirmó el 1 de septiembre que su próximo modelo de frontera, llamado Astra, alcanzó el umbral de capacidad «crítica» en ciberseguridad dentro de su Marco de Preparación (Preparedness Framework), la calificación más alta que la compañía asigna a un modelo y la primera vez que designa un sistema en ese nivel. Según la publicación técnica de la empresa, titulada «Path to Astra», el modelo puede identificar fallas de seguridad desconocidas y desarrollar formas de explotarlas en sistemas altamente protegidos sin que una persona lo guíe paso a paso.
OpenAI había advertido en agosto que no podía descartar que Astra alcanzara ese nivel y, como consecuencia, frenó partes del desarrollo del modelo mientras reforzaba y probaba salvaguardas contra el uso malicioso y las acciones no autorizadas del sistema. Tras esas pruebas adicionales, la compañía concluyó que las protecciones actuales minimizan de forma suficiente el riesgo de daño severo como para habilitar el lanzamiento. El despliegue será escalonado: las capacidades ofensivas más avanzadas del modelo estarán disponibles primero para un grupo reducido de organizaciones que integran la coalición de ciberseguridad Daybreak, con claves de seguridad de hardware obligatorias para todas las cuentas desde el 1 de septiembre.
El anuncio marca un punto de inflexión para toda la industria de modelos de frontera: es la primera vez que un desarrollador documenta públicamente que uno de sus sistemas cruzó la línea de «crítico» en un marco de autoevaluación de riesgos, y la Casa Blanca confirmó que OpenAI informó voluntariamente sobre la decisión de demorar el lanzamiento. Auditores externos, incluido el Instituto de Seguridad de IA del Reino Unido, participaron de pruebas adicionales sobre el modelo antes de esta designación, un nivel de escrutinio inusual para una compañía privada.
La dimensión humana del caso es doble: por un lado, un modelo con esa capacidad podría convertirse en una herramienta defensiva poderosa para equipos de seguridad que hoy enfrentan una escasez crónica de talento especializado; por el otro, la misma capacidad, si cae en manos equivocadas o escapa a los controles de acceso escalonado, podría automatizar ataques que hasta ahora requerían equipos humanos altamente calificados. La pregunta que queda planteada para el resto de la industria de IA es si otros laboratorios llegarán pronto al mismo umbral y qué estándares comunes de acceso restringido deberían adoptarse antes de que eso ocurra.
La inteligencia artificial generativa ha dejado atrás la etapa en la que un simple modelo de lenguaje bastaba para resolver la mayoría de los problemas. Hoy el valor real se encuentra en la composición de varias capas especializadas que trabajan juntas: modelos base, técnicas de recuperación de información, agentes autónomos, frameworks de orquestación y runtimes listos para producción. Esta nota explica de forma continua y técnica cada una de estas capas, sitúa a los actores principales en su lugar exacto dentro del stack y muestra cómo convergen en sistemas reales. El objetivo es ofrecer una visión clara, funcional y actualizada para quienes diseñan o implementan soluciones de IA en entornos productivos.
Los modelos de lenguaje como base de razonamiento
Todo el ecosistema se apoya en los grandes modelos de lenguaje. Estos modelos son el motor de razonamiento y generación de texto. Claude, de Anthropic, destaca por su capacidad de razonamiento profundo, uso de herramientas y funciones como Computer Use. Los modelos de la familia GPT de OpenAI siguen siendo una referencia de uso general. Los modelos Hermes, desarrollados por Nous Research, están optimizados especialmente para comportamientos agentic e instruction following. También existen opciones open-weight y locales que pueden ejecutarse con Ollama o vLLM. Ninguno de estos modelos, por sí solo, tiene acceso nativo a datos privados actualizados ni capacidad de ejecutar acciones de forma persistente. Por eso necesitan de las capas que se describen a continuación.
RAG como técnica de grounding
Retrieval-Augmented Generation, o RAG, surgió como la solución más directa al problema de las alucinaciones y del conocimiento estático de los modelos. El flujo clásico consiste en convertir la pregunta del usuario en un embedding, buscar los fragmentos más similares en una base vectorial, inyectar esos fragmentos en el prompt y dejar que el modelo genere la respuesta. Esta técnica es eficiente, de bajo costo y latencia predecible. Funciona muy bien para consultas factuales simples sobre documentación interna, políticas de empresa o bases de conocimiento. Sin embargo, su naturaleza pasiva y de una sola pasada la hace insuficiente cuando la pregunta requiere conectar información de varias fuentes o razonar en varios pasos.
Los agentes de IA y el paso a la autonomía
Un agente de IA va más allá de generar texto. Opera en un bucle de razonamiento, acción y observación. Recibe un objetivo, decide qué herramientas utilizar, ejecuta acciones, observa los resultados y ajusta su plan hasta completar la tarea. Puede llamar APIs, consultar bases de datos, navegar por la web, ejecutar código o interactuar con sistemas externos. La diferencia fundamental con un sistema RAG puro es que el agente no solo responde: actúa y decide. Esta capacidad abre la puerta a la automatización de flujos de trabajo completos, desde la investigación hasta la ejecución de tareas operativas.
Agentic RAG: la fusión de recuperación y autonomía
Agentic RAG representa la convergencia natural entre la técnica de recuperación y la autonomía de los agentes. En esta arquitectura el agente controla el proceso de retrieval. Decide si necesita buscar información, reformula la consulta, elige entre varias fuentes, evalúa la calidad de lo recuperado y vuelve a buscar si es necesario. Solo genera la respuesta final cuando considera que tiene suficiente evidencia. Este enfoque resuelve las limitaciones del RAG clásico en consultas multi-hop y ambiguas, aunque introduce mayor latencia y costo por las múltiples llamadas al modelo. Es el patrón que se utiliza hoy en asistentes de investigación, sistemas de soporte técnico avanzado y análisis complejos que cruzan datos internos y externos.
Los frameworks de construcción: LangChain y LangGraph
Para construir estos sistemas de forma controlada y mantenible se utilizan frameworks de orquestación. LangChain ofrece abstracciones estándar para modelos, embeddings, vector stores, herramientas y agentes. Facilita el desarrollo de cadenas y la integración de múltiples componentes. LangGraph, construido sobre la misma base, permite modelar el flujo como un grafo de estados con persistencia, ejecución durable, human-in-the-loop y streaming. Es la herramienta preferida cuando se necesita control fino sobre el comportamiento del agente o sistemas multi-agente. Ambos son open-source y se han convertido en el estándar de facto para implementar Agentic RAG y arquitecturas agentic personalizadas.
Los runtimes de agentes listos para producción
Una vez que se tiene la lógica de orquestación, aparece la necesidad de ejecutar el agente de forma persistente y accesible. Aquí entran los runtimes. Hermes Agent, desarrollado por Nous Research, es un agente autónomo open-source con un learning loop incorporado. Crea skills a partir de la experiencia, mantiene memoria persistente entre sesiones y mejora con el tiempo. Puede ejecutarse en un servidor propio, en la nube o de forma serverless, y admite cualquier modelo, incluido Claude. OpenClaw, por su parte, se orienta más a la accesibilidad multi-canal. Corre en el dispositivo del usuario o en un servidor y se conecta de forma nativa a Telegram, WhatsApp, Discord, Slack e iMessage, entre otros. Ambos son MIT y gratuitos para self-hosting. Representan la capa de experiencia de usuario y persistencia operativa.
Cómo convergen todos estos elementos
La arquitectura moderna no elige entre RAG, agentes o frameworks. Los combina según la necesidad. Un sistema típico de producción puede tener a OpenClaw o Hermes como interfaz y runtime persistente, LangGraph como capa de orquestación y control de flujo, herramientas de Agentic RAG para la recuperación inteligente de conocimiento, y Claude u otro modelo potente como motor de razonamiento. El resultado es un sistema que puede recibir una instrucción por Telegram, decidir qué información necesita, recuperarla de varias fuentes, razonar sobre ella y ejecutar acciones, todo manteniendo contexto a lo largo del tiempo.
Criterios prácticos de decisión
Cuando la necesidad es únicamente responder preguntas sobre un corpus de documentos con baja latencia, el RAG clásico sigue siendo la opción más eficiente. Cuando las consultas son complejas o multi-fuente, se recomienda subir a Agentic RAG implementado con LangGraph. Si el objetivo es automatizar flujos de trabajo de extremo a extremo, se construye un agente con el mismo framework. Cuando se busca un asistente personal que esté siempre disponible y mejore con el uso, Hermes Agent o OpenClaw ofrecen una base sólida. Y cuando se requiere control total y personalización profunda, se desarrolla todo sobre LangChain y LangGraph.
Consideraciones de producción
En entornos reales adquiere especial importancia la observabilidad. Herramientas como LangSmith permiten trazar cada decisión del agente, medir costos y detectar fallos. El control de herramientas, el uso de sandboxes y la inclusión de human-in-the-loop son prácticas recomendadas para limitar riesgos. La memoria debe distinguirse entre la de sesión y la persistente de largo plazo. Finalmente, la evaluación debe ir más allá de la precisión de la respuesta e incluir métricas de trayectoria del agente y de fidelidad a las fuentes recuperadas.
Conclusión
El stack actual de IA generativa es una composición de capas especializadas. Los modelos aportan el razonamiento, RAG aporta el grounding, los agentes aportan la autonomía, los frameworks aportan el control y los runtimes aportan la persistencia y la accesibilidad. Entender el lugar exacto de cada actor permite diseñar sistemas más eficientes, controlables y alineados con el problema real que se quiere resolver. Esta convergencia es la base sobre la que se construyen hoy las aplicaciones de IA más avanzadas.
Documentación oficial de Agentic RAG y patrones: sitios de IBM, LangChain y papers de arXiv sobre Agentic Retrieval-Augmented Generation.
Comparativas y casos de uso de Hermes y OpenClaw: documentación oficial de ambos proyectos y análisis técnicos de 2026.
Todos los componentes open-source mencionados (LangChain, LangGraph, Hermes Agent y OpenClaw) pueden descargarse e instalarse de forma gratuita bajo licencia MIT. Los costos aparecen únicamente al utilizar APIs de modelos propietarios como Claude o al desplegar infraestructura en la nube.











 AI1 año ago
 Nano1 año ago

 AI10 meses ago

 AI1 año ago