Connect with us

Bio

¿Qué es la Biología Sintética?

¿Qué es la Biología Sintética?

Publicado

on

Photo: Shutterstock


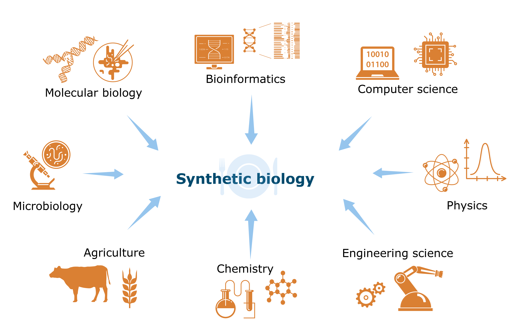
La biología sintética es una disciplina revolucionaria que combina biología, física, química y tecnología de la información para diseñar y crear sistemas biológicos nuevos o mejorados. A diferencia de otras ramas de la biología, como la ecología o la biología médica, se asemeja más al diseño industrial. Los científicos toman componentes biológicos, como proteínas, ADN, microorganismos y células, y los combinan de manera innovadora para desarrollar aplicaciones que antes parecían ciencia ficción. En la Wageningen University & Research (WUR), esta ciencia se utiliza para mejorar la producción de alimentos, promover la salud y crear un entorno más sostenible.

A primera vista, la biología sintética puede parecer similar a la biotecnología, pero va un paso más allá. Mientras la biotecnología busca mejorar organismos existentes, la biología sintética crea sistemas completamente nuevos, diseñados desde cero con un enfoque basado en la ingeniería.

Enfoque Interdisciplinario

El avance de la biología sintética ha sido impulsado por el desarrollo de computadoras y modelos informáticos avanzados. Hoy en día, existen bases de datos extensas que detallan las características de bacterias, proteínas y genes, incluyendo su estructura, comportamiento y funciones. Los científicos pueden aislar genes de un organismo y transferirlos a otro, otorgándoles capacidades nuevas, como la producción de sustancias específicas. Este conocimiento permite simular y combinar elementos biológicos de formas previamente inimaginables, abriendo un abanico de posibilidades.

Aplicaciones de la Biología Sintética

Producción de Medicamentos

Las bacterias son fundamentales en la biología sintética debido a su facilidad para ser modificadas genéticamente y su rápida reproducción. Por ejemplo, los científicos pueden insertar genes en bacterias para que produzcan medicamentos en grandes cantidades. A diferencia de la modificación genética tradicional, que depende de ensayo y error, la biología sintética diseña el ADN en computadoras antes de implementarlo en el laboratorio, gracias al conocimiento detallado de proteínas y genes.

Diagnóstico de Enfermedades

Un ejemplo innovador es el trabajo del equipo iGEM 2017, que desarrolló un dispositivo llamado Mantis para diagnosticar enfermedades tropicales. Utilizando bacterias equipadas con aficuerpos (moléculas que reaccionan específicamente a patógenos), el dispositivo detecta la presencia de enfermedades mediante señales de luz ultravioleta. Este método es más barato, preciso y adaptable que las pruebas tradicionales, lo que lo hace ideal para responder rápidamente a nuevos patógenos.

Detección de Contaminantes

Las bacterias también pueden actuar como sensores. Por ejemplo, se han creado bacterias que detectan TNT y cambian de color en su presencia, permitiendo localizar explosivos de manera segura. De manera similar, se están desarrollando bacterias que funcionan como una «nariz artificial», capaces de identificar gases o sustancias específicas, con aplicaciones en seguridad y monitoreo ambiental.

Estimulación del Crecimiento de Plantas

En la agricultura, la biología sintética optimiza las comunidades microbianas del suelo para mejorar el crecimiento de las plantas. Bacterias específicas producen nutrientes como nitrógeno y fósforo, previenen enfermedades y promueven el desarrollo hormonal de las plantas. Encontrar la combinación ideal de microorganismos para cada tipo de planta y entorno es un desafío clave que esta disciplina está abordando.

Creación de Nuevas Formas de Vida

La biología sintética no solo modifica organismos existentes, sino que también crea nuevos. Proyectos como BaSyC (Building a Synthetic Cell) buscan construir células funcionales desde cero, combinando propiedades de diferentes organismos. Esto podría llevar a la creación de materiales sostenibles, combustibles biodegradables y alimentos más saludables. Además, se están desarrollando virus sintéticos para vacunas y órganos modelo, como el «gut-on-a-chip», que simula el intestino humano para estudiar interacciones biológicas.

Impacto Social y Consideraciones Éticas

La biología sintética tiene el potencial de transformar la sociedad al abordar problemas como la seguridad alimentaria, la salud y la sostenibilidad. Sin embargo, también plantea dilemas éticos y sociales. El uso de organismos genéticamente modificados y formas de vida sintéticas genera preguntas sobre seguridad y moralidad. Por ejemplo:

  • ¿Cuáles son los riesgos a largo plazo de modificar ecosistemas, como al introducir mosquitos que no transmitan malaria?

  • ¿Qué sucede si el conocimiento de la biología sintética se usa con fines maliciosos, como la creación de virus patógenos?

  • ¿Quién debería tener la propiedad de las formas de vida sintéticas y sus beneficios económicos?

En WUR, los científicos dialogan constantemente con la sociedad para priorizar aplicaciones y garantizar que los desarrollos sean seguros y éticos. Estas discusiones son esenciales para equilibrar el progreso científico con la responsabilidad social.

Juegos para Explorar la Biología Sintética

Para quienes deseen experimentar con esta disciplina, la empresa Biofaction ha creado juegos basados en proyectos reales:

  • SynMod: Desarrolla un antibiótico para combatir patógenos. Disponible en App Store y Google Play.

  • Juego de Hacer Bayas: Dirige una empresa que produce bebidas usando biología sintética, gestionando precios y demandas del mercado. Disponible en App Store y en línea.

Conclusión

La biología sintética está redefiniendo lo que es posible en la ciencia, desde bacterias que producen medicamentos hasta células construidas en laboratorio. Aunque sus aplicaciones son prometedoras, también exige un enfoque cuidadoso para abordar los desafíos éticos y sociales. A medida que esta disciplina avanza, su capacidad para mejorar la salud, la agricultura y el medio ambiente dependerá de la colaboración entre científicos, la sociedad y los responsables de políticas públicas.

Saludos 

Claudio R. Parrinello

Continue Reading
Advertisement
Click to comment

Leave a Reply

Tu dirección de correo electrónico no será publicada. Los campos obligatorios están marcados con *

Bio

Un sistema de edición genética busca ampliar las opciones frente a CRISPR

Publicado

on

Una investigación desarrollada por científicos vinculados a Cornell describe un sistema de edición genética diseñado como alternativa potencial a CRISPR. Según la cobertura de BioTechniques, el sistema fue probado en bacterias y plantea una vía para ampliar el repertorio de herramientas de ingeniería genética.

CRISPR revolucionó la edición genética porque permite dirigir modificaciones a secuencias determinadas del ADN. Sin embargo, no todas las herramientas sirven para todas las aplicaciones: la eficiencia, el tipo de modificación, el tamaño del sistema y los efectos no deseados pueden limitar su uso en determinados organismos o contextos experimentales.

La demostración en bacterias es un primer paso y no prueba que la herramienta funcione con igual eficacia en células humanas, plantas o animales. Para evaluar su importancia será necesario examinar la publicación científica original, los tipos de cambios que puede realizar, las tasas de éxito y los límites de seguridad.

Una alternativa funcional podría ampliar las posibilidades de investigación en biotecnología industrial, agricultura y desarrollo de tratamientos. El interés para América Latina incluye cultivos, microorganismos industriales y salud, pero cualquier aplicación concreta deberá superar etapas de validación, evaluación de riesgos y regulación.

Fuentes:

BioTechniques: https://www.biotechniques.com/genetic-engineering/new-gene-editing-system-offers-promising-crispr-alternative/

Continue Reading

Bio

Una proteína humana diseñada abre nuevas vías para editar ARN

Publicado

on

Nature Biotechnology publicó una investigación sobre una versión diseñada de Argonaute 2 humana para realizar edición dirigida de bases de ARN, en particular conversiones de citosina a uracilo (C-to-U). El artículo explora la posibilidad de aprovechar una proteína humana con funciones programables para superar algunas limitaciones de herramientas basadas en proteínas de otros organismos.

La edición de ARN se diferencia de la modificación directa del ADN: puede alterar instrucciones moleculares utilizadas por las células sin cambiar necesariamente la secuencia permanente del genoma. Una herramienta capaz de dirigir estas modificaciones podría ofrecer nuevas estrategias de investigación y, potencialmente, aplicaciones terapéuticas.

El trabajo se encuentra en el ámbito de la investigación científica. No debe interpretarse como la disponibilidad de un tratamiento aprobado ni como evidencia de eficacia clínica general. La precisión de la edición, los efectos fuera del objetivo, la entrega a los tejidos y la duración de los cambios requieren evaluación específica.

El avance es relevante para la convergencia entre biología molecular e ingeniería de proteínas. Para los investigadores de la región, la publicación puede orientar nuevas líneas de estudio en terapias basadas en ARN, aunque la traducción a productos médicos dependerá de la validación independiente y de ensayos posteriores.

Fuentes:

Nature Biotechnology: https://www.nature.com/articles/s41587-026-03359-y

Continue Reading

Bio

¿Puede la IA acelerar la investigación genética sin perder trazabilidad?

Publicado

on

La respuesta corta es sí, pero solo si se construye deliberadamente una infraestructura de trazabilidad desde el diseño. Los modelos de IA entrenados en ADN, ARN y proteínas (Evo 2, Nucleotide Transformer, AlphaFold 3, ESM-3, LucaOne y similares) están convirtiendo la biología en una disciplina cada vez más programable. Generan hipótesis, diseñan secuencias y predicen estructuras a una velocidad imposible para la experimentación clásica. El riesgo es evidente: si no se preserva la cadena de custodia de los datos, de los modelos y de los resultados, la aceleración se convierte en una caja negra opaca, irreproducible y vulnerable a manipulación o a violaciones de privacidad.

La solución emergente combina estos foundation models biológicos con blockchain (y técnicas criptográficas asociadas) para recuperar y potenciar la trazabilidad, la reproducibilidad, la auditoría y la protección de datos.

El problema de la trazabilidad en la era de los modelos biológicos

Los modelos de lenguaje genómico y proteico se entrenan sobre corpus masivos (billones de nucleótidos, cientos de millones de proteínas). Una vez entrenados, producen predicciones o diseños de novo que luego se validan (o no) en el laboratorio. Los puntos débiles son varios:

  • Origen de los datos: ¿de qué cohortes, con qué consentimientos y bajo qué licencias se entrenó el modelo?
  • Versión del modelo y del pipeline: pequeños cambios en hiperparámetros, en el preprocesamiento o en la versión de AlphaFold/Evo pueden alterar resultados.
  • Manipulación post-hoc: una predicción puede ser alterada después de generarse sin dejar rastro evidente.
  • Datos personales sensibles: los genomas humanos son identificadores únicos; compartirlos sin control viola GDPR, HIPAA y normas equivalentes.
  • Reproducibilidad experimental: incluso cuando el diseño in silico es correcto, la tasa de éxito en el laboratorio sigue siendo limitada (a menudo 10-20 % en binders), y sin un registro inmutable es difícil saber exactamente qué se intentó y por qué falló.

Sin trazabilidad, la “biología programable” se parece más a una caja negra de alto rendimiento que a una ciencia auditable.

Cómo entra blockchain

Blockchain no resuelve el plegado de proteínas ni genera secuencias mejores. Su valor está en tres propiedades: inmutabilidad, descentralización y transparencia verificable. Aplicado a la investigación genética, se usa de forma híbrida:

  1. Datos genéticos fuera de la cadena (off-chain)
    Los archivos grandes (FASTQ, BAM, VCF, genomas completos) se almacenan cifrados en IPFS, Arweave, bases de datos federadas o nubes permisivas. Solo se registra en la cadena el hash criptográfico del archivo, el metadato de consentimiento y los permisos de acceso.
  2. Eventos de proveniencia y uso en la cadena (on-chain)
    Cada acción relevante se registra como transacción: secuenciación de la muestra, control de calidad, acceso por un investigador, entrenamiento o fine-tuning de un modelo, generación de una predicción, envío a síntesis y resultado experimental. El registro es inmutable y con marca de tiempo.
  3. Modelos y predicciones verificables
    Sistemas recientes calculan un hash del input (secuencia o conjunto de datos), un hash del modelo (pesos o versión) y un hash de la predicción, y los anclan en un smart contract. Cualquier auditor puede verificar después que la salida proviene exactamente de ese input y de ese modelo, sin necesidad de ver los datos sensibles. Esto ataca directamente el problema de manipulación post-hoc de resultados de IA.

Ejemplos concretos ya publicados incluyen:

  • PrecisionChain (Nature Medicine, 2024): plataforma de consorcio que unifica datos clínicos y genéticos, permite consultas combinadas genotipo-fenotipo y mantiene logs de acceso inmutables.
  • Sistemas de federated learning con blockchain (FFT-GA-BC y similares, 2026): entrenan modelos de forma distribuida sin compartir genomas crudos, usan privacidad diferencial + cifrado homomórfico y registran cada ronda de agregación en una cadena con pruebas Merkle.
  • Esquemas de verifiable AI para farmacogenómica: cada predicción de sensibilidad a fármacos se ancla on-chain junto con los hashes de input y modelo, permitiendo auditoría posterior sin revelar el genoma del paciente.

Reproducibilidad y auditoría

La trazabilidad criptográfica permite responder preguntas que hoy suelen quedar en el aire:

  • ¿Qué versión exacta del modelo y qué datos de entrenamiento produjeron este diseño de proteína o esta predicción de variante?
  • ¿Quién accedió a qué cohortes y con qué consentimiento?
  • ¿El resultado experimental corresponde al diseño que se registró, o hubo cambios no documentados?

Cuando se combina con contenedores deterministas, versionado de pipelines (Nextflow, CWL) y registro de hashes de resultados intermedios, se acerca a una reproducibilidad computacional “a prueba de auditoría”. Algunos trabajos experimentales ya demuestran que flujos de análisis de estructura proteica respaldados por blockchain logran 100 % de reproducibilidad en verificaciones de integridad, aunque con un coste computacional adicional.

La auditoría se vuelve continua y no solo retrospectiva: reguladores, comités de ética o revisores de revistas pueden verificar la cadena de custodia sin necesidad de acceder a los datos crudos.

Protección de datos y gobernanza

Los genomas son datos personales de alto riesgo. Blockchain, bien diseñado, refuerza la protección en lugar de debilitarla:

  • Consentimiento programable: smart contracts pueden codificar condiciones de uso (solo investigación de cáncer, solo con anonimización, solo hasta cierta fecha) y revocar acceso automáticamente.
  • Propiedad del individuo: el paciente o el donante puede mantener control sobre quién usa su genoma y, en algunos modelos, recibir micropagos o “dividendos de biodatos” cuando su contribución se usa para entrenar un modelo.
  • Privacidad por diseño: zero-knowledge proofs permiten demostrar propiedades (por ejemplo, “este genoma pertenece a un paciente con mutación X”) sin revelar la secuencia completa. El cifrado homomórfico y el aprendizaje federado permiten entrenar o consultar modelos sin descifrar los datos.
  • Cumplimiento regulatorio: logs inmutables facilitan demostrar cumplimiento de GDPR, HIPAA u otras normas ante auditorías.

Los enfoques más maduros son híbridos: datos sensibles siempre off-chain y cifrados; solo hashes, metadatos de consentimiento y eventos de acceso van a la cadena. Las cadenas de consorcio (permisivas) suelen ser más adecuadas que las públicas para datos genómicos por razones de rendimiento, coste y control de acceso.

Límites reales y desafíos pendientes

No todo es solucionable con blockchain:

  • El coste de gas y la latencia todavía limitan el registro de cada micro-evento en cadenas públicas.
  • La escalabilidad de almacenamiento on-chain de genomas completos es inviable; el modelo híbrido es obligatorio.
  • La calidad de la trazabilidad depende de que los actores (laboratorios, empresas de IA, hospitales) registren honestamente los eventos desde el origen. La tecnología no impide que alguien mienta en el primer eslabón.
  • La interoperabilidad entre distintas blockchains y sistemas legacy de biobancos sigue siendo un problema técnico y de gobernanza.
  • El riesgo de “lavado de trazabilidad”: un sistema puede tener hashes impecables y, sin embargo, basarse en datos de origen dudoso o en modelos sesgados.

Además, la aceleración de la IA no elimina la necesidad de validación experimental. La trazabilidad perfecta de un diseño in silico no garantiza que la proteína se pliegue o funcione en la célula.

Conclusión: aceleración con memoria

La IA puede acelerar de forma radical la investigación genética —diseño de proteínas, predicción de efectos de variantes, generación de circuitos sintéticos, análisis multi-ómico— siempre que se construya al mismo tiempo una capa de memoria criptográfica. Blockchain no es la solución mágica, pero es una de las pocas tecnologías que ofrece inmutabilidad, auditoría pública o semi-pública y control granular de acceso a escala multi-institucional.

El escenario deseable es un ciclo cerrado:

dato genético con consentimiento → hash y registro de proveniencia → entrenamiento o inferencia de modelo biológico → predicción/diseño anclado on-chain → síntesis y experimento → resultado registrado → actualización del conocimiento compartido.

Cuando ese ciclo está trazable de extremo a extremo, la velocidad de la IA deja de ser una amenaza a la integridad científica y se convierte en una herramienta auditable, reproducible y respetuosa con la privacidad. La biología programable solo será verdaderamente científica si conserva la memoria de cómo se programó.

Continue Reading

TENDENCIAS